- codexvn2026-08-18
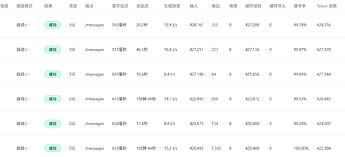
问题1:token速度的问题
一但上下文到达一定程度,token速度会剧烈下降,怀疑是glm对于长上下文的情况或者命中很多缓存的情况会有单独的调度策略
问题2:作为国内模型,写出来的文档国人有巨大的阅读负担,尝试过claude.md约束但是效果不大,主要表现为:
英文术语直译成中文
✗ 宿主调用并发闸门(16)→ ✓ 宿主调用并发上限控制(同时最多 16 个回调)
凭空出现的缩写
✗ 变更分 A/M/D 三类 → ✓ 变更分为新增(A,Add)、修改(M,Modify)、删除(D,Delete)三类
用隐喻和黑话代替明确描述
✗ 把这个约定钉死 → ✓ 明确约定并落实到文档
✗ 双真相 → ✓ 双数据源
✗ 方案已落地 → ✓ 方案已实施完成
压缩式/省略式表述
✗ 无敏感信息入文档 → ✓ 敏感信息不写入文档
✗ 旧债策略;禁止新债 → ✓ 旧技术债处理策略;禁止引入新技术债
主楼 - jcc2026-08-18
这个已经比gpt强一些了,gpt那个更是看不懂
- 还想成为88VIP2026-08-18
这玩意这么慢吗,那可以和k3并称双区兄弟了,这俩哪个更慢?
- yu17452026-08-18
钱没给够导致的,钱给够了的GLM Max的首字速度和DS一样都是秒出字