- 天上火2026-09-04
先说结论 就是 aa 自己的问题
首先 aa 作为一家前沿人工智能分析机构,他们当前的基准测试分析做的实在是太失败了 根本就配不上大家对它的信任
aa 推出这个 人工智能分析指数的目的是为了分析各大前沿 AI 的综合能力,但现在这个排行榜已经完全无法反应现实情况,甚至显得十分谬误
为什么这么说?
抛开 muse1.3>astra 这个一眼就能看到的离谱排名不谈 在 aa 的排行榜上竟然还存在另外一个极其离谱 让我怀疑 aa 处于平行宇宙的排名
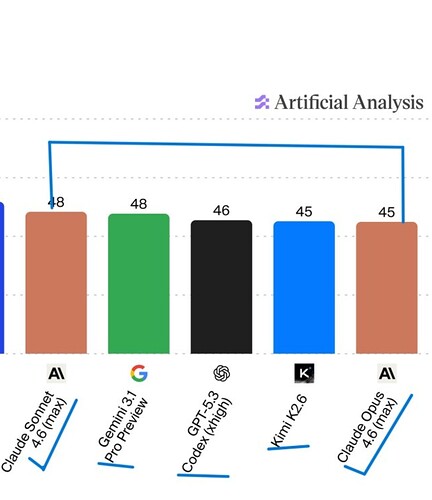
什么叫做 claude 4.6sonnet>claude 4.6opus ??? 这是一家前沿人工智能分析机构能排出来的排名?
还是说我们所处的宇宙和 aa 的宇宙不一样 我实在无法理解 claude4.6sonnet 凭什么比 4.6opus 强
除了排名上的失真 aa 所挑选的基准测试 以及他们的权重排比也出现严重失衡问题
首先 关于基准测试 我们不难发现 AA “精心挑选”出的基准测试 几乎大部分都存在严重的问题
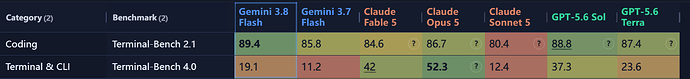
先说Terminal-Bench v2.1 又名工作台编码基准 这套基准测试早在上个月就更新到了 4.0 版本 之前的版本因为方法论上的缺陷 无法诚实的反应模型的真实水准早就被各大 AI 厂商弃用了(当然 某某厂商还没有弃用 发布新模型时猛猛地对这条基准刷分 结果在 4.0 版本跑分翻车被大伙笑话到现在^-^ ) 甚至Anthropic 在发布 fable5.1 的时候干脆直接取消使用这条基准
而 aa 至今还在沿用 v2.1 这个老版本 甚至还赋予了很高的得分权重 …
再说 Humanity’s Last Exam 又名 hle 人类最后的考试 考验的是多学科专家知识推理能力
这条基准测试更是重量级选手
早在去年 就有人锤这条基准测试“完全不可用”百分之 17 的题描述就不准确 甚至描述的是错误的说法 百分之 30 的题标准答案都错了这答案都错了是最离谱的
然而就是这种神人基准测试 我们的 aa 一样照单全收 而且除了收这些有缺陷的基准测试 aa 还收录了几个早就已经饱和和数据污染的测试
然后再配上极其不合理的权重 比如这几个明显有缺陷的基准测试 本身的得分权重竟然还比正常的基准测试高
那这下子好了 claude4.6sonnet>claude4.6opus 了 muse1.3>astra 了
所以 现在 aa 的人工智能榜单完全没有任何参考意义是真的 这家机构也是真的神 成功把自己的锅甩到了 OAI 身上 导致一大波不明真相的人在哪里嚷嚷起 oai 的 astra 翻车了
实在是无语至今
主楼 - calendar2026-09-04
AAA 模型测试王总
- 不韦2026-09-04
先说Terminal-Bench v2.1 又名工作台编码基准 这套基准测试早在上个月就更新到了 4.0 版本 之前的版本因为方法论上的缺陷 无法诚实的反应模型的真实水准早就被各大 AI 厂商弃用了(当然 某某厂商还没有弃用 发布新模型时猛猛地对这条基准刷分 结果在 4.0 版本跑分翻车被大伙笑话到现在 ^-^ )
这是谁啊,有知道的吗??
- Faeries2026-09-04
没事,就看AA表演就好,回头Astra表现如果真突出,AA绝对是要被清算的。
- wayned2026-09-04
我一直看 DeepSWE,不过最近好像也被刷得参考价值下降了
- ajeow2026-09-04
- wuha2026-09-04
deepswe被刷饱和了,AA的一些组成指标过时了
- mark2026-09-04
当野榜看个笑话吧,排名第三的模型谁能绷住 ^-^
- wayned2026-09-04
楼主也没说没告诉啊,说得也不是这个问题
- supermadmax2026-09-04
虽然AA是野榜,但是大家都还没用上Astra,不能排除它会翻车的可能性吧 ^-^
- 还想成为88VIP2026-09-04
有一说一,没必要澄清,说实话我已经看不懂现在的排行榜了,opus5跑分基本上稳压fable5,但是我还是觉得fable5更好,感觉现在排行榜的参考意义有限
- BOOSTMEISTER_2014_DH2026-09-04
不敢苟同,我肯定不管 artificialanalysis,不会替它辩护,我很早之前,他们这个还是 v4 版本,我在 v2、v2.1 版本就说过这个问题,但是这本来就很难。我是不看这个总分的只看小榜。你不可能弄出一个合理的计算方法。我不仅想算智能指数,我还想把输出冗余度、甚至不同模型在不同强度测试上的得分也算进去。
额说多了,
terminalbench2.1 确实慢了,我看的也是 v4,HLE 也确实是有问题的。
但是,我觉得这个“因为 musespark 和 sonnet4.6 的分更高所以不合理”这个完全站不住,被刷分了又不是算法的问题,sonnet4.6 就是比 opus4.6 要分高,这就是个刷分模型,任何一个排行榜,如果反而因为“我被刷分了我不能让刷分模型更高”,而暗调算法,这是可笑的。
- 兰子p2026-09-04
但是muse spark 1.3这个东西真的是一用一个不吱声 ^-^
- mawai2026-09-04
评分啥的仅供参考,真正还要看使用感觉,没必要纠结这些
- MoZiHan2026-09-04
当然是我们最不刷分最不营销的gemini3.8flash ^-^
- shyrock2026-09-04
- BOOSTMEISTER_2014_DH2026-09-04
没问题啊,别的不说,前端、单网页、 OneShot Opus5 确实大于 Fable5。任何测试集总有一定的局限性。我用的也是 fable5,不喜欢 opus5 我甚至用 opus4.6 也不想用 5,但是这跟排行榜有什么关系呢。
要专业,专业就是要实事求是。再怎么对不上体感,那也是计算方法的问题。绝对不能因此而人为去加修正系数什么的
- sxjeru2026-09-04
- 还想成为88VIP2026-09-04
所以说不靠谱啊,当初opus4.7也是大部分都强于4.6,要我说这些榜基本上都不靠谱,这些排行榜本来是提供参考,现在几乎失去了参考价值,肯定有关系
他们爱怎么测是他们的事,我作为路人甲我是觉得要一个一个论的话没几个榜是靠谱的
- 西门卤蛋2026-09-04
AA和deepSWE是德不配位,不是故意作恶,但是再不更新就真要被淘汰了。