- 宙方2026-09-05
前几天刚买了两台 DGXSpark
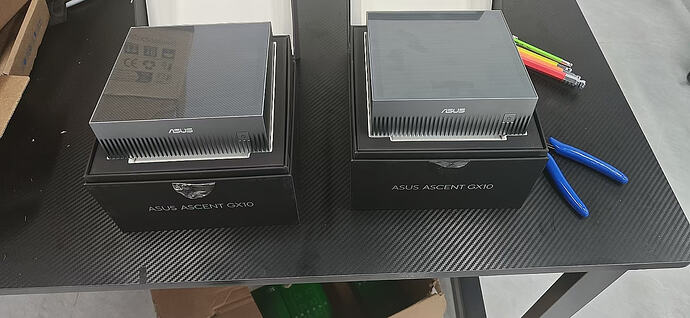
然后部署GLM5.3Flash,目前社区里面 效果最好、速度最快(相对)的方案是
Mia-lab的
MiaAI-Lab/GLM-5.3-Flash-EXL3-2x-DGX-Sparks: GLM-5.3 Flash EXL3 for 2x DGX Sparks
但是它prose decode只有27tps左右 结构化代码会提高 在真实harness上下文中实际速度甚至只有24-30波动,还是偏慢了。
然后让Astra直接帮我定制化内核,在不损失精度的情况下优化解码速度,
/goal 进一步优化Decode速度,从推理引擎、spark专属内核、GLM5.3flash特性、双机数据交换等方面入手,善用GitHub、huggingface、context7等互联网手段,专为该模型优化。
然后
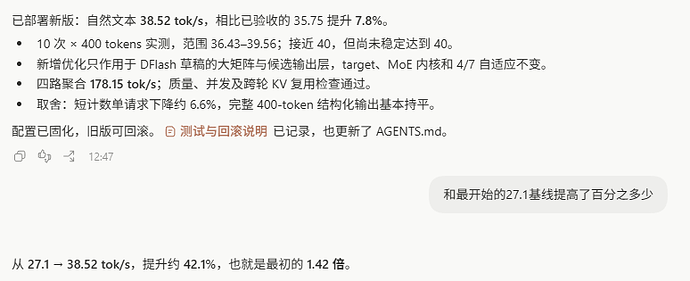
本地部署 在DSH 实测
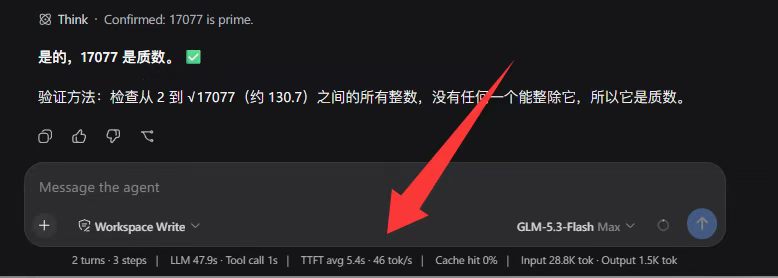
相当可用了 在超过300k上下文仍然超过30tps,已经跟API速度差不多了。 ^-^
主楼 - wayned2026-09-05
强啊,本地部署 ds4f,和 5.3f 比怎么样?
- 宙方2026-09-05
我感觉5.3f要更强,而且dv4fv由于视觉能力的预测解码草稿模型这些还没训练得很好,速度快不了多少。
- AnimalCollective2026-09-05
本地部署是不是做逆向啥的完全没限制啊
- 宙方2026-09-05
有破甲版本 完全无限制
- nikaidouyui2026-09-05
这个是量化版本吧和官方api有多少性能损失?
- Jack2026-09-05
卧槽,涨见识了。两个小主机查了下,三万多一台。佬,方便说下俩小机器能帮你做哪些事。学习下。
- 宙方2026-09-05
专门选择的EXL3 4btw量化格式 损失极小
- nikaidouyui2026-09-05
那就是7w左右就能私有化部署glm5.3flash做到官方的能力?? ^-^ 这么便宜?
- 宙方2026-09-05
- 宙方2026-09-05
但是只能单并发
- chinajojo2026-09-05
最好四台,英伟达的dgx spark最多可以四台互联组成计算,把四台拉满最好
- AnimalCollective2026-09-05
8 张 RTX 3090(总显存 192 GB)、376 GB 内存、72 线程 CPU
请教下佬,我这边有个这样的服务器资源可以使用,能部署5.3flash顺畅使用吗,Qwen3.8 27b是不是不如5.3flash