发现自己对1M上下文的需求并不高
1112
- surf2026-09-10
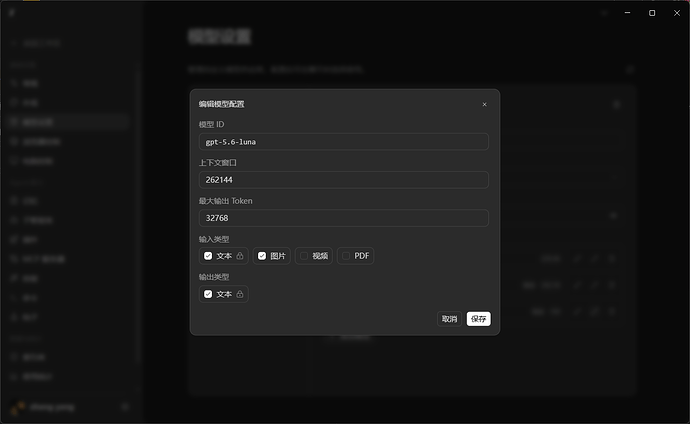
之前在论坛看过一张图,好像是说模型上下文越多,模型会变得越傻,200k处于刚好的状态.
同时,我也发现上下文越长,模型首字越慢,反而200k也刚刚好.
有没有佬友有不同意见和建议的
主楼 - 未央花2026-09-10
写最开始的需求开发方案文档,长上下文还是很有帮助的。
- Scheme2026-09-10
- xiayi2026-09-10
- Dew2026-09-10
因为受到注意力影响,上下文越多,注意力越稀释。
- 冰原Bill2026-09-10
本来是无所谓那点降智的,但是astra的缓存读价格太离谱了,只能缩到400k以内用。
- I_Love_AI2026-09-10
感觉不够啊,随便一个代码,没交代几轮就超了。看着压缩就烦
- Pepper2026-09-10
其实现在Astra到500k左右都没什么损失了,甚至1M的8 neddles test都能到90+的分数,但是太贵了,所以我现在用的400k压缩
- 不是风球2026-09-10
一直用的默认的二百多k 没怎么碰到过压缩中断或者失忆的问题
- Scheme2026-09-10
 immortalbeating2026-09-10
你要确保agent的压缩机制能满足你的需求,不然压缩就是代表信息丢失,codex是远程压缩做的好,gpt5.5时候就感觉一个会话能用N久
- Vanta2026-09-10
上下文越多,注意力越容易丢失, 如果压缩机制能做的更好一些的话
- i2026-09-10
这些说是1m上下文,实际上3,4百万的时候就不中用了