- IPScopes2026-09-13
我怎么感觉和V4 Flash 差别不大呀,难到是客户端的问题,为用的codex调用的
主楼 - 咸鱼-linuxdo2026-09-13
至少速度差别巨大吧,v4.1快多了
- llliiilll2026-09-13
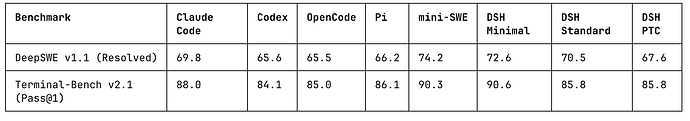
不要用codex,论文里codex基本上是分最低的,用dsh的标准模式吧
- Hummooorrr2026-09-13
一个是用dsh的标准模式,另一个是high可能比max好用
- llliiilll2026-09-13
- 太阳之子2026-09-13
我也用了三天,明显太多了,4.1f是新基座,最明显的就是喜欢做验证,特别是截图验证这个动作,还有喜欢搞一堆雷霆测试,写几行代码搞几十个角度的测试文件最后跑一堆token,
更喜欢以自己的习惯去做这件事,就算你告诉他了,他也不一定听你的。
而且不能开最大思考,非常容易陷入雷霆大思考,这个问题不管在ds哪个版本都会出现。
而且有概率触发陷入循环思考直到打满上下文。
- IPScopes2026-09-13
codex分值这么低?
- IPScopes2026-09-13
是的,不听使唤,然后我让他每次开始前从记忆里复读一次规则
- 时牧2026-09-13
那有点像提了速的lunamax
- 0x00000002026-09-13
发布用到现在了,今天中午又回去GPT了
速度快,性能也不错,我是部署在DSH上的,用哪个引导思维链的插件+全程MAX思考
但对于比较复杂一点的项目,能力还是不行,处理出来的数据一塌糊涂
我做因子挖掘的,处理出来的的数据毫无严谨性,这方面的能力不得不说,GPT+CODEX真的独一档
- L站周杰伦2026-09-13
已经发布了 V4.1 Flash 模型了吗?我还不知道呢