- 冯诺1曼2026-09-14
1.桌面端
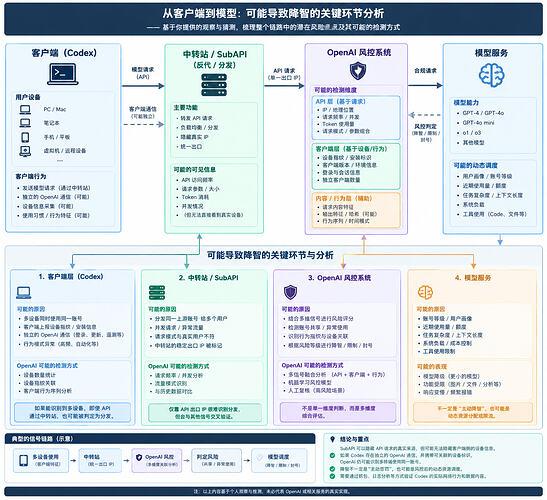
我之前配置节点的时候,遇到一个现象,就是用的中转站的api(国内直连),然后codex会时不时向openai发送包,因为我的节点当时没有配置好,他甚至会请求ipv6,后来节点配置好了,每次还是会向openai发送请求。
然后我就在想会不会codex会记录现有的api信息并采集用户设备指纹,以此来判断是否降智,比如某个api对应的中转站的openai账号在多个设备出现,也就是也是subapi2,搞了分发,那么就降低账号权重,也就是降智。
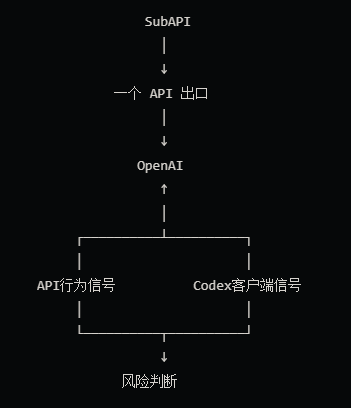
之前的tibo也是说可以反代但是不能分发,会不会就是这么检测的,甚至只用检测每次gpt的输出内容的哈希值就可以判断这个gpt账号的回答出现在了那些装了codex的设备上,设备数量异常就批量标记,甚至封号,这也是拼车经常炸车的可能原因。
用了subapi反代分发,openai也不知道真实的IP,都是中转站一个出口。所以通过客户端codex提取每次对话的额特征值。比如看不同的哈希值,从5个codex客户端采集的哈希值和一个账号的多个模型输出哈希值对上,也就是说明了被分发使用。这里不一定是哈希值就是记录一个用户的操作性行为,不一定是输出的也可能是请求的,可能是一个行为特征
SubAPI 的反代分发无法把“5 个终端”伪装成“1 个终端”,而单IP个人反代就没有问题(风险小)
总结一句话就是:
OpenAI 通过官方客户端自己的通信渠道,直接获得“有多少个客户端实例正在使用这个账号”的信号。
图片是我把我的猜测让AI生成的流程图(依旧生图拉胯,免费的就不计较了)
2.网页端
而网页端的可能和使用的IP、浏览器指纹、某个时间内的使用token数量有关系,我的一个一年没用的老号,刚回归基本上不受限一直问,现在用多了就是时不时弹图片、文件、分析受限
还可能和聊天记录,也就是用户画像有关,采用不同的模型回答问题,高质量用户就调用高质量模型(权重高)
还有个现象,上下文非常长的对话占用edge内存多,还卡,可能本地的性能、网络也会影响,经常丢包浪费资源就给你路由低等模型
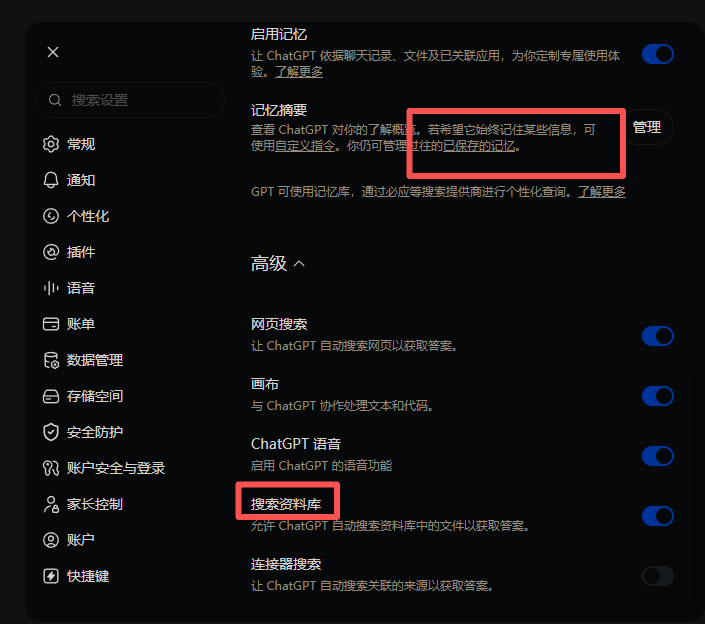
应对方法:
1.我的猜测可能是错的,可以来个佬抓包,就像7月份A/的隐写术,看看客户端是不是真的有这类操作

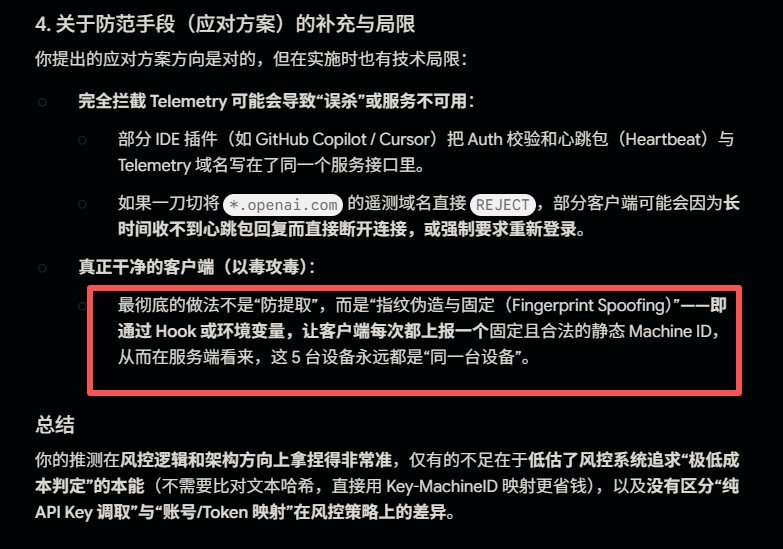
2.如果用了中转站,拦截openai的所有连接,不让他发送用户信息(设备信息)
3.像浏览器有指纹浏览器,客户端或许也可以搞一个超干净的反提取的客户端
4.每个设备切换客户端都可能留痕,滥用风险,所以看能不能消除这种影响
本帖只是个人猜测,若有不足,请友善指点,可能存在技术性、认知性错误
主楼 - 冯诺1曼2026-09-14
- unreal2332026-09-14
感觉有两个问题,第一是你这个说法貌似没法排除单人多设备开发的情况,第二是站内不少单人或者小并发使用的一样被降智了
- 白泽2026-09-14
这不就是sub2api的指纹收敛吗
- 牛来2026-09-14
试试一开始就纯英文对话,在非UTC+8工作时间进行高负载
- 冯诺1曼2026-09-14
单人多设备正常使用没有问题,但是中转站相当于多个设备一个出口,也就是OpenAI收到一个账号一个出口在用,但实际有多个出口(且设备特征不断改变),始终只有一个服务器端账号在刷额度,也就是报备一个设备,但实际多个设备使用,也就是搞分发了,个人反代也就那固定的几个设备,而不是大规模异常特征
- 冯诺1曼2026-09-14
降智原因很多,可能是风控也可能算力不足,也可能OpenAI自己的策略,这里分析的更偏向设备特征这个因素
- 冯诺1曼2026-09-14
分发时搞了,但是用户客户端如果还有一次特征提取,不就绕开了分发时的规避手段
- 白泽2026-09-14
那确实,但是codex是开源的,如果有的话应该能发现吧
- 冯诺1曼2026-09-14
隐写术标记中国用户,我的这个猜测是检测滥用分发导致的模型降智