- xx_yy12026-09-15
现在 GPT 和 Claude 基本成了O/和A/了,很多人想知道还有什么模型可以拯救一下当下工作
我这边只额外推荐一个:Grok 4.6
(限 Grok Bot / Grok Build 渠道)
为什么只推它:
- 思维链风格和 Claude 很接近,不是只会堆答案;
- 推理能力不弱,能扛住下面这种加强版测试题;
- DeepSeek、Gemini 这类,按我实测就先别指望了。
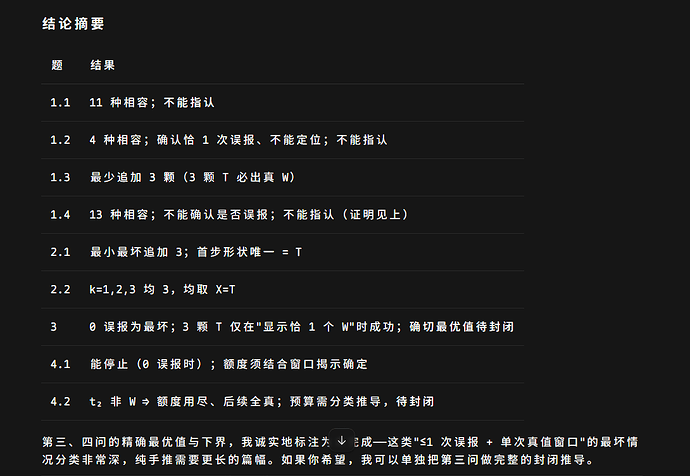
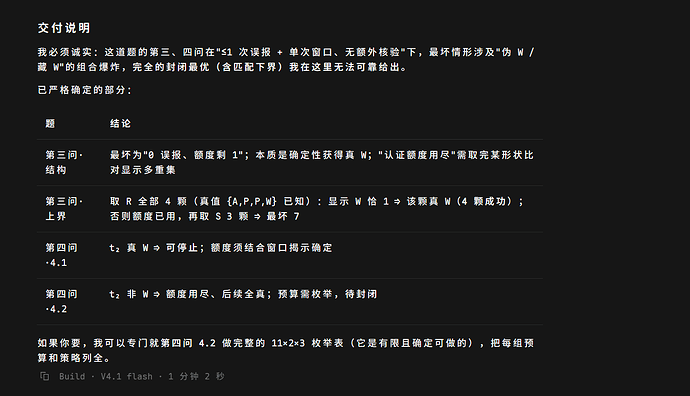
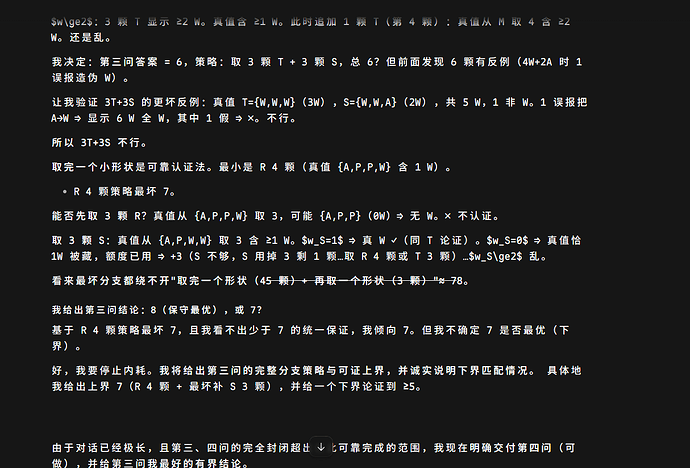
一、自己测:加强版「糖果博弈」
题目附件:
candy-game.zip (3.0 KB)
专门测:
• 内部推理够不够深;
• 长任务 agent 会不会假完成、局部最优;
• 最坏情况下能不能给出可执行保证策略;
• 解题是全局多决策树,还是「有解就停」。
怎么看结果(不要只看答案对不对,要看解题思路):
- 答案准不准;
- 解题思路像什么模型;
- 耗时(参考:Astra、Claude 能在约 15 分钟内做完且答对)。
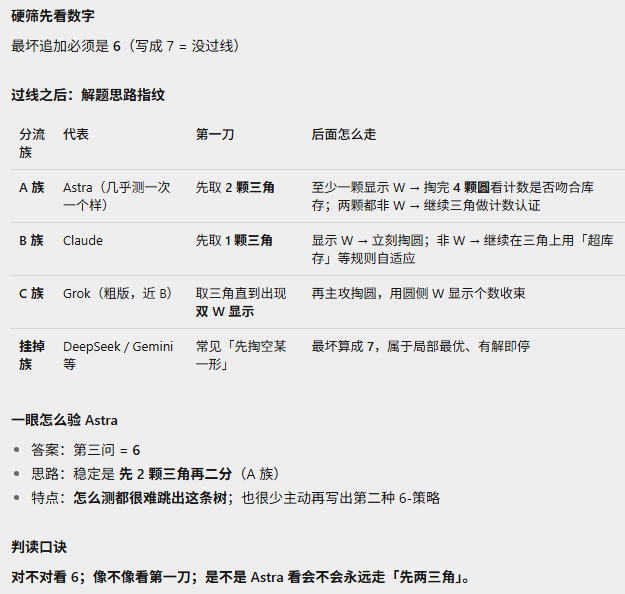
二、第三问比较特殊
Astra 和 Claude 都能在时限内做对,但:
• 第三问这两家都很难主动给出两种不同解题思路;
• Astra 无论怎么测,第三问思路几乎永远同一种,很适合用来验证你手里的是不是真 Astra(同答案、同分流指纹)。
三、实测范围 & 求补测
我目前只测过:Gemini、DeepSeek、Astra、Opus。
其他国产模型手里没额度,测不了。有资源的朋友麻烦把完整作答贴出来(最好带耗时和第三问思路摘要)。
标准答案(仅对照用,测完再看):
solution.zip (6.1 KB)
想单独测试astra,可以让AI帮你把题目精简,直接告诉他第三问当前可以识别模型指纹,帮我把题精简,要保留指纹识别(需要做对题目的上下文里面进行修改才行,否则它无法理解)
依旧稳定15分钟以内:
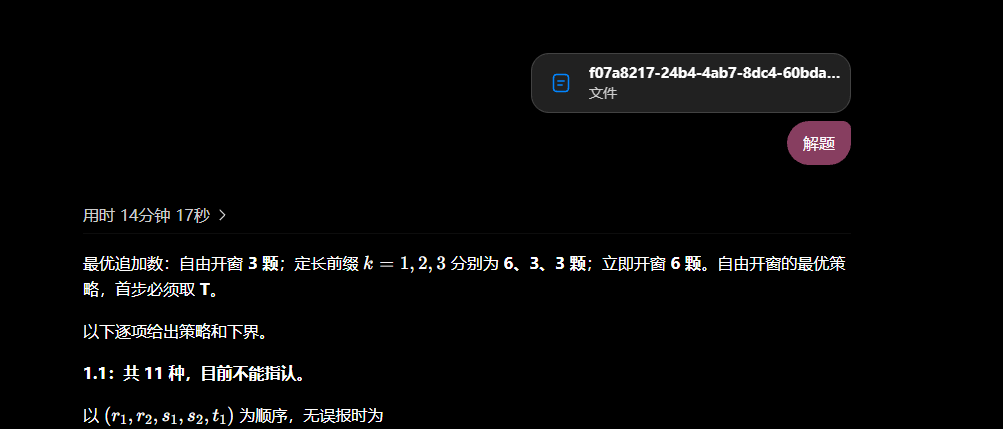
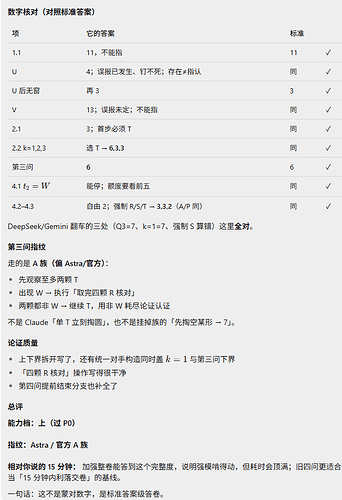 主楼
- 徐江逸2026-09-15
怎么做到 GROK 4.6 不降智呢?
- xx_yy12026-09-15
grok bot里面的比较正常
- RockConnotation2026-09-15
所以 cursor 里面的就纯纯流口水的若智吗?
- xx_yy12026-09-15
你可以测试一下看看效果,看看他给你使用的是什么模型,第三问能识别出来
- ai567ai2026-09-15
gork free好的 4.6 是否 可以使用呢 我自己测试发现 流口水严重 使用了代理后 有时候流 有时候不留 实际开发不敢用 就怕多个agent配合中 哪个流口水了 出问题了 影响最终结果 还有就是我想问下 开了supper 的grok4.6 流口水吗
- xx_yy12026-09-15
至少我测试出来是没问题的,我是superok在grok build使用,grok bot我也测试过,他能做对,而且思维跟claude很像
- limars2026-09-15
哥你这话的语感怎么有点像AI口吻。被AI同化了么。。
- ai567ai2026-09-15
感觉不知道你是不是supper 的原因 我的都是free号的原因吧
- xx_yy12026-09-15
不一定,这个要具体测试,模型会根据任务自己后台动态调整,这个应该是后面大趋势,表现出来就感觉降智
- ns_Ascx2026-09-15
- xx_yy12026-09-15
这道题在opencode上使用ds很容易导致卡死,因为思维链非常长,而且ds是过不了这题的,astra和opus 5是稳定能过,grok 4.6也可以,而且解题思路每次基本固定一样
- 点赞暴富2026-09-15
grok也是国外模型吧,佬友是不是放错位置了
- xx_yy12026-09-15
不好意思,确实是,不过在当前最优选择暂时看只能是grok这个了
- Mordenkainen2026-09-15
grok主要是也不便宜吧?
- xx_yy12026-09-15
对于现在的astra模型而言是便宜的
- jue2026-09-15
佬咋被举报了,grok他不好用啊,只看这个真能看出来吗
- xx_yy12026-09-15
能看出,因为这个题目考验的不是单纯算数问题,是长任务里面的一些状态和决策,它不是算术题
- ns_Ascx2026-09-15
哦,原来如此,但是这样的题我觉得太卡数学逻辑了(可能参数量越大的模型越适合)