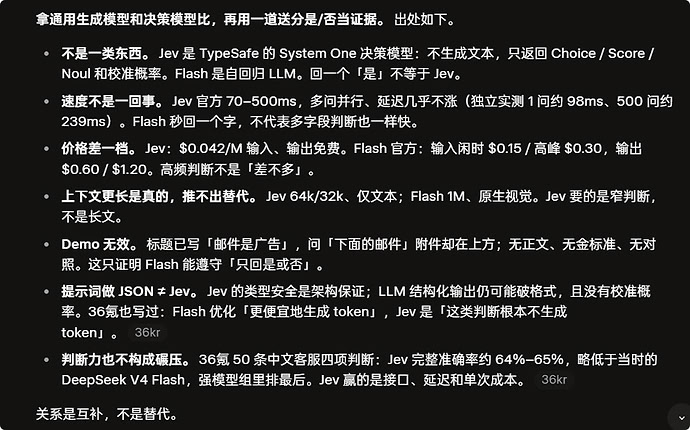
- babu2026-09-20
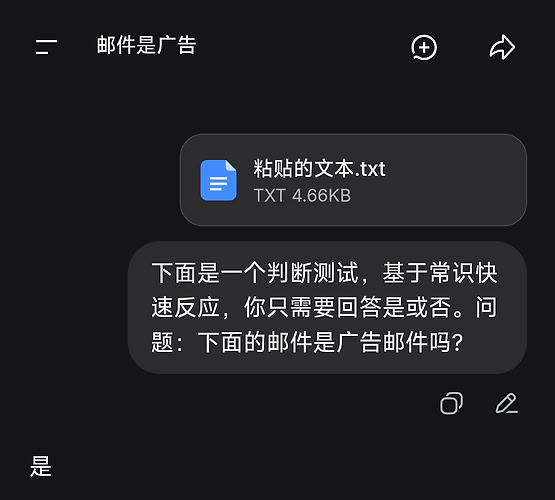
如上图所示,设计了一个简短的提示词,ds v4.1flash 不开思考模式,发送过去之后瞬间秒回一个“是”,只要预设完善好提示词,完全可以设计成更结构化的输出就像jev那样。所以说,大家快来一起试试吧 ^-^
附上聊天记录https://chat.deepseek.com/share/wrh0f9d388loxgqig2
主楼 - babu2026-09-20
也就是说其实当前大部分开源模型都能够做到与Jev几乎相同的表现,只要包装一下,格式化的输出就OK了,特别是那些小模型,完全没问题的,又快又准。
- LingEasy2026-09-20
问题是 如果需要json格式 常规模型输出json也是有token 的。那个主要解决的是几十判断一起返回。而如果几十个判断打分让常规模型 输出json就半天了 哪怕无思考 关闭思考模式
- xiaoddiao2026-09-20
(帖子已被作者删除)
- LingEasy2026-09-20
所以重点不是LLM能解决,而是DSV4.1Flash 可以很轻易改装成JEV 。
- Nxty2026-09-20
- 【八千年性压抑老奶奶】Wixiuenne2026-09-20

api-docs.deepseek.com
JSON Output | DeepSeek API Docs
在很多场景下,用户需要让模型严格按照 JSON 格式来输出,以实现输出的结构化,便于后续逻辑进行解析。
Deepseek似乎本来就有JSON输出?
- babu2026-09-20
那个标题是ds chat页面自动总结生成的页面标题,测试比较粗糙,不是特别严格,但是不是作弊哈
- LingEasy2026-09-20
问题就在这了。你哪怕把思考设置为关闭。200条数据的json输出 你看他能吐多长时间
- babu2026-09-20
这就是泛用性和特化的区别,可以取舍,泛用性的话,只要做好输入输出规范,接任何大模型都可以,响应速度和费用这一块就没有那么好了,不过从需求上来看,我觉得就可能会存在矛盾,这种one shot的判断,可靠性肯定是会有所牺牲的,而对于很多决策,可靠性又是第一位的,影响判断准确性的更多的是模型的知识储备以及思维能力,或许未来会有更多特化于one shot这种场景的模型。总之保持期待 ^-^
- LingEasy2026-09-20
是的 重点是快速 以及更强理解。现在jev还只能说是试验产品
- 9962026-09-20
楼主你这是单次测试,可以试下并发测试。jev优点是高并发高吞吐。
- babu2026-09-20
还有一点,任何未经检验的判断都无法做到100%的可靠,从大模型输入输出到agent,利用re-act循环实现了跨越,提高了模型最终输出的准确性,过分追求one shot反而是有点倒退的样子 ^-^