- 逍遥2026-09-21
由加州理工(Caltech)团队创立的 AI 实验室 PrismML 发布了名为 Ternary Bonsai 2 27B 的三值量化模型。
该模型基于阿里的 Qwen3.8 27B,通过三值量化(权重仅为 -1, 0, +1)配合 FP16 分组缩放,将模型体积从全精度的约 54GB 压缩至 5.9GB,平均有效位宽为 1.76-bit。
模型在数学(保留99.5%)、代码(保留99.3%)和指令遵循(反超基座)方面表现极佳,几乎无损。
劣势在需要长程推理和复杂工具调用的 Agent 任务中,性能保留率约为 75%(例如 SWE-bench 和 Terminal-Bench 得分有明显下降)。因此,它非常适合本地代码补全、短链路任务,但在处理复杂长链条任务时能力会有折损。
模型权重下载位置
Hugging Face:
prism-ml/Ternary-Bonsai-2-27B-gguf
魔搭 ModelScope:
prism-ml/Ternary-Bonsai-2-27B-gguf
官方博客:
https://prismml.com/news/bonsai-2-27b
Apache 2.0(可商用)
有没有佬部署试过?
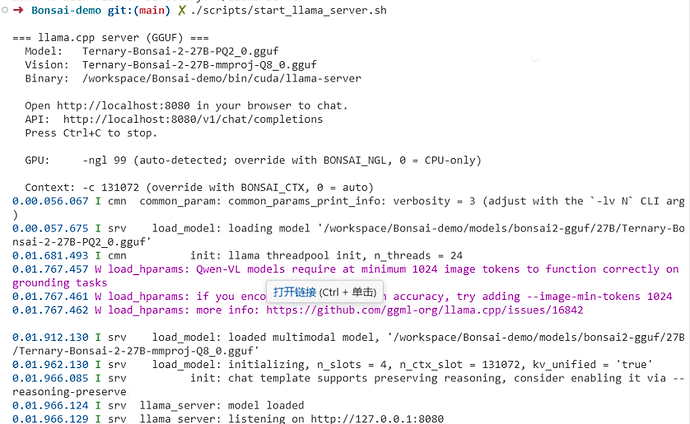
我这两天在外面,等回去试试我的8G小卡能不能跑起来。
主楼 - NukaColaM2026-09-21
- 6101002026-09-21
效果咋样?有没有测一下编程或者逆向能力? ^-^
- 就不告诉你2026-09-21
- 你的绿坝2026-09-21
多少?多强?这下又要看到椅子爆炸倒在核弹上了
- outgoing2026-09-21
- NukaColaM2026-09-21
用来搞了一两个简单的CTF题,有是有,但还是太慢了。本身就雷霆大思考,再加上输出慢,两眼一黑。
- Yunshaochu2026-09-21
- NukaColaM2026-09-21
上个kvmem,能跑128K的
- 逍遥2026-09-21
佬,跑个鹈鹕骑车看看效果怎么样呢?咋配合kvmem一起用啊?
- JamesLi2026-09-21
2080ti22g试过了,鹈鹕跑自行车就飞了,但是跑秦始皇骑北极熊竟然还行。还有其他的测试题目吗?
- MuTuLG2026-09-21
这压缩率也太夸张了,以后部署大模型是不是都不用买显卡了?
- MisakaMikoto2026-09-21
我的5080终于有用武之地了,有空试一下
- NukaColaM2026-09-21
kvmem已经出一个bonsai的分支了,直接切分支编译
- jerry2026-09-21
- wanlan2026-09-21
这种模型做企业的智能问数和知识问答应该绰绰有余了吧
- RyanVan2026-09-21
过几年本地部署Astra级模型不是梦
- 闻人慕远z2026-09-21
做测试,原模型不也是要做测试的,然后计算各个测试的得分,量化模型一样做测试看看得分,反正大模型这种东西就是个黑盒,只能通过测试进行能力判断
- YonderSeek2026-09-21
跑benchmark,但是benchmark一般都会刷分过拟合,实际体验感觉会降低不少性能
- Piao2026-09-21