- hehezi2026-09-21
如题,商汤目前free的tokenplan给的lao1还是挺多的,个人使用基本足够
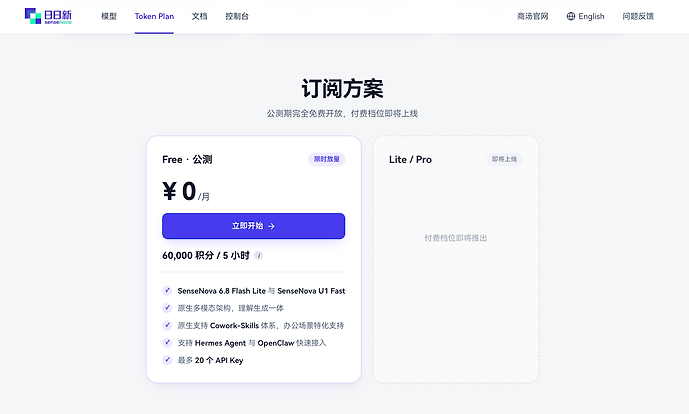
但是限流非常恶心,基本上kimi,glm,deepseek连着发2-3条就直接触发限流
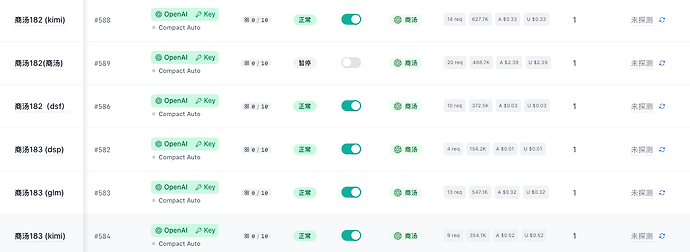
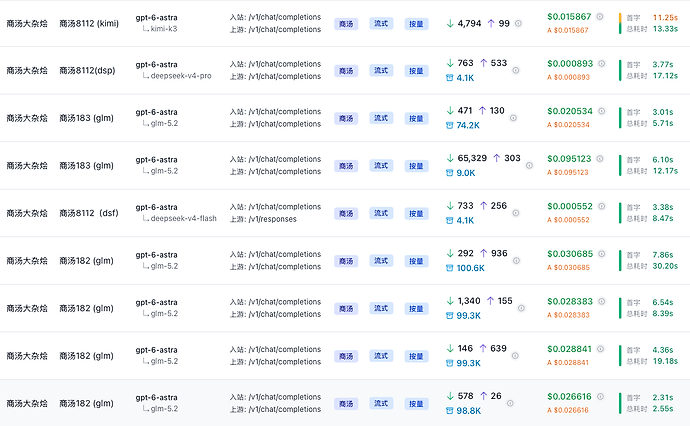
于是乎,题主把一个账号(手机号就行)每个模型单拆出来,放到sub2里,统一对外暴露一个模型名称,这里使用的是gpt-6-astra,自用实测没有再触发过任何限流,也能顺畅的跑任务
 主楼
- hehezi2026-09-21
- anyuge2026-09-21
大佬怎么实现的,求具体实现方法啊
- hehezi2026-09-21
(帖子已被作者删除)
- xie666-linuxdo2026-09-21
但是你一定要使用一个模型就不行了只能做做简单任务每次任务模型都不一样,你指定一个模型用就不行了
- hehezi2026-09-21
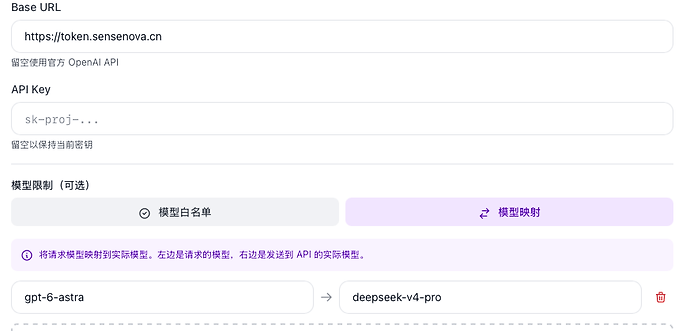
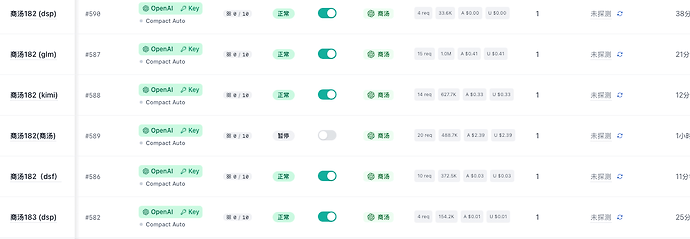
实测5个模型可以用,我是在sub2api里一个账号复制5份,每份添加一个gpt-6-astra到指定一个模型的路由,图上是deepseek-v4-pro。其他账号就分别路由到glm,kimi之类。
- hehezi2026-09-21
是的,指定一个模型一两条消息就限流了,所以复制成多个账号轮询
- 天涯若比邻2026-09-21
- anyuge2026-09-21
多账户轮询的话,那会不会出现,轮询一遍以后,再问其他问题的时候也继续限流呢?
- hehezi2026-09-21
是的,这种每个模型限流的,轮询就很大程度避免了。我目前还没遇到apikey的rpm限流
- hehezi2026-09-21
我刚测试了半天,目前没遇到,某个模型限流的话就自动切号了。我开了池模式+429冷却1分钟,这样账号不会被429停止调度
- anyuge2026-09-21
你现在几个号在进行轮询工作
- 天涯若比邻2026-09-21
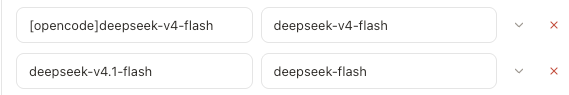
我这里主要是有的上游,它渠道特别多,也不稳定,光一个 DeepSeek-Flash 可以搞四五个模型名,大写的,小写的,带后缀的,不带后缀的。
关键是可用性还不固定,一会这个可以用,一会那个又可以用。
如果我只是用在 Hermes 里面,我就想让它直接轮询全部模型得了,哪个能干用哪个,而不是我一直来回切。
也是困扰我挺久的,我还没想到怎么做比较好
- xie666-linuxdo2026-09-21
用axonhub很方便你可以看一下
- 干啥啥不行2026-09-21
CPA的别名啊。
- 无风2026-09-21
网址在哪里啊?有谁知道?
- sunfly2026-09-21
在 Claudecode 中请求 glm5.2 不报错吗?
- raitozjz2026-09-21