- Charlin_Chen2026-09-21
最近刷到不少Jev相关的视频,我看了一下,似乎是把文本生成任务变成了概率预测,这不就是之前的Bert吗?只不过现在变成了prompt微调的bert了,不需要像bert那样在领域内收集训练语料了。从应用层面上讲,似乎替代的是传统的语义分类和重排序,不知道我理解的对不对?
主楼 - NICAI2026-09-21
文本生成任务无论LM的size不都是next token prediction吗
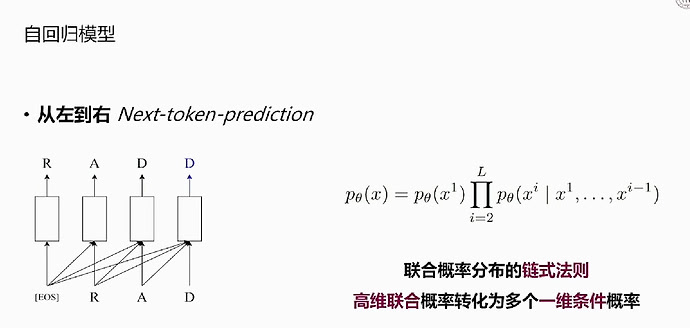
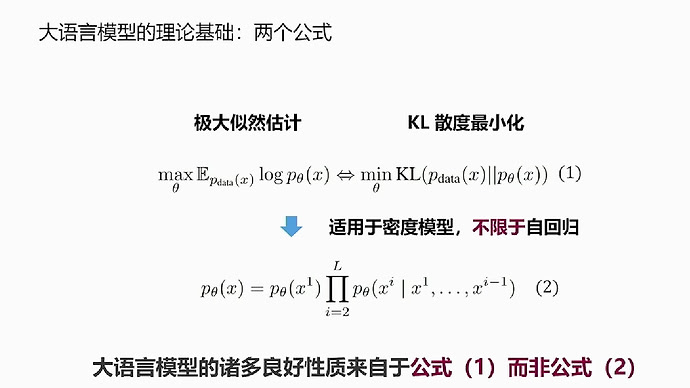
佬可能是表达错意思了

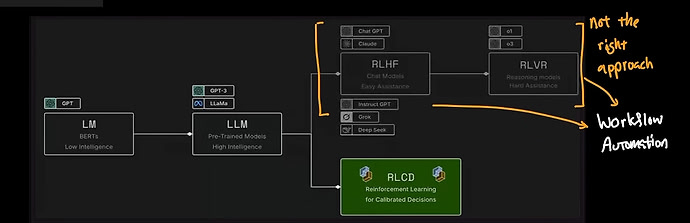
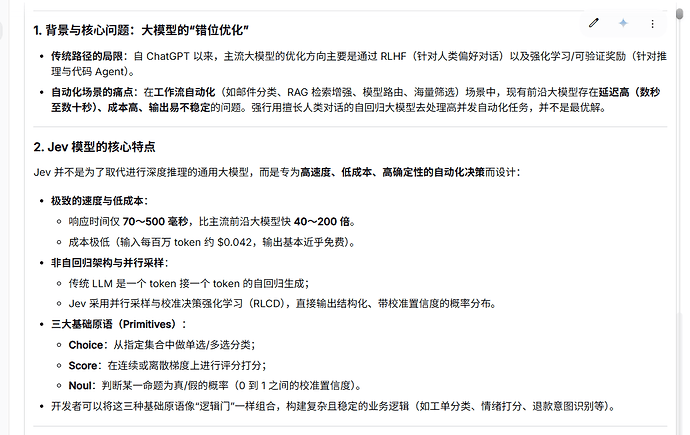
根据这个视频,相比于基于人类偏好训练的会说话的通用的LLM用于做事,jev更多是将自动化工作流中的决策(结构化的文本段)当作概率预测
- lee52026-09-21
使用体验上可以这样认为,但是官方说的决策方向(类似 VLA)倒是有所不同