- MarchBeta20872026-09-22
2万亿参数(2T)在训练中,8万亿参数(8T)规划中

鉅亨網 – 22 Sep 26
DeepSeek大模型再暴衝 2兆參數訓練中、下一步挑戰8兆 | 鉅亨網 - 大陸政經
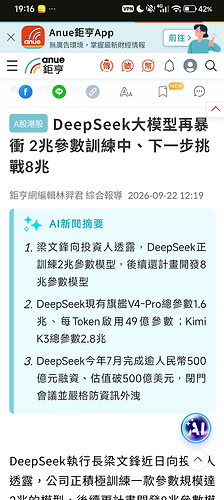
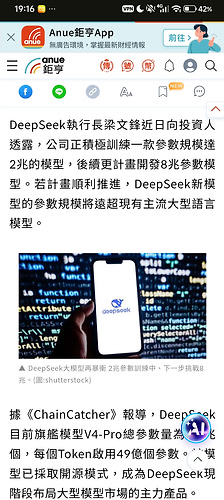
梁文鋒向投資人透露,DeepSeek正訓練2兆參數模型,後續還計畫開發8兆參數模型
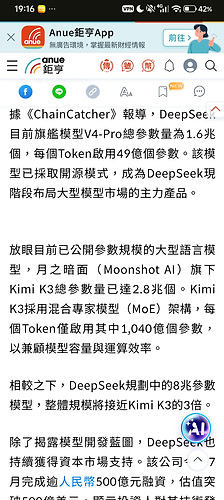
DeepSeek現有旗艦V4-Pro總參數1.6兆、每Token啟用49億參數;Kimi K3總參數2.8兆
DeepSeek今年7月完成逾人民幣500億元融資、估值破500億美元,閉門會議並嚴格防資訊外洩需要注意的是,这里面的“兆”是港台用法,大陆是百万,港台是万亿
 主楼
- V_Arrow2026-09-22
1.6T的V4P都炼炸了,2T 8T还能把握得住么 ^-^
- ensemble2026-09-22
v4.1pro应该就是这个2T模型了。8T的有点难以想象啊,deepseek有这么多卡吗?fable和astra应该也没有这么大吧 ^-^
- Humpy2026-09-22
不好说,他们不公布体积肯定不是因为体积小,尤其是fable
- xiedian2026-09-22
按照v4.1 flash是版本最小参数的说法,再加上v4 pro炼炸了,接下来应该是一个v4.1中等参数的模型,中等参数没问题,最后可能才是v4.1完全体
- 初九猫2026-09-22
deepseek-v4.1说是“该系列最小的模型”的时候我就预料到了,至少这个系列有三个模型,现在就看最大的模型叫什么名字了……deepseek-v4.1-max?
- 时牧2026-09-22
值得注意的是^-^早上我在x看到同款消息,是那种蓝钩营销号发的
这不会是x上的小道消息吧

AI Weekly
DeepSeek CEO Liang Wenfeng Calls Huawei Training Chips One of Company's...
The Information reports DeepSeek founder Liang Wenfeng told investors that training on Huawei chips is one of DeepSeek's biggest strategic bets, with…
还行,只是添油加醋了
应该真的在训 2 万亿参数的4.1pro
- yangkl2026-09-22
参数越大,推理费用是不是就越高了,后边还能愉快用AI吗
- blless2026-09-22
有也很正常吧,v4.1 flash跟v4 flash架构差距那么大,推出时间才一个月左右。说明底模肯定已经训练好了,按ds尿性,4.1pro肯定已经在训练了啊。
- Myallure2026-09-22
ds极致稀疏化,感觉应该还行
 心雨2026-09-22
这两位之前就有传言上10t了,有些营销号吹的更夸张,绝对小不了
- Z-linuxdo2026-09-22
考虑到astra出来后O的算力都这么紧张,感觉应该是一个挺大的模型
- DROP_TABLE.user_info2026-09-22
对咯!梁子你听叔的,你把握不住~
- Stesla2026-09-22
^-^灰测呢?灰测模型怎么不放出来了^-^^-^^-^