- junwei522026-09-23
今天用glm 5.3改一个项目的前端(整体改,由Tk 桌面端改成Vue 3 + Element Plus + Tailwind CSS),消耗token太快了,一下子就干了2.1亿token,基本上掐着5小时来搞,5小时额度不到半个小时就消耗完额度了。想问下用glm的佬这个正常吗?用的是睿动ai购买的glm v2 pro套餐。原厂key。另外请教下有没有使用glm的技巧,能省点token的。太难了,感觉还没gpt耐用!
主楼 - war12026-09-23
我也是用的这个 glm v2 感觉消耗好快 基本周额度三天就花完了 五小时最多四个小时就花完了
- Chisa2026-09-23
下午高峰期,V2套餐应该是3倍消耗吧我记得
- junwei522026-09-23
不是高峰期也快
- junwei522026-09-23
是啊,感觉不大正常,但是理论说用的原厂key,应该用不了手脚啊!不知道v3 pro的消耗怎么样!
- hatsuka2026-09-23
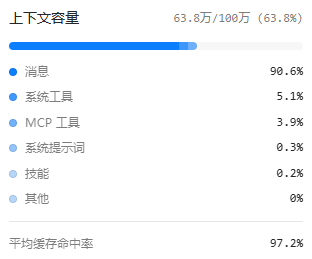
这个如果上下文长了,消耗是很恐怖的,尽量上下文不要太长吧
- junwei522026-09-23
- 心诚则无敌2026-09-23
消耗快就卖了 目前卖个1.5k-2k应该有人买 我的就是前几天卖的
- junwei522026-09-23
我买的睿动AI的套餐,不是官网的套餐
- 行思渐远2026-09-23
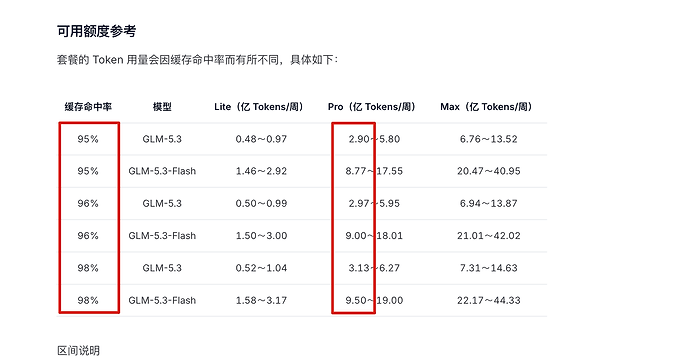
zcode里用才能保证高缓存率,我用zcode,感觉还行,5.3比5.3 flash额度消耗也快,睿价格差很多,动那个套餐就是老的v2套餐
- junwei522026-09-23
我就是在 Zcode里面使用.
- 行思渐远2026-09-23
- Mordenkainen2026-09-23
你可以早点手动压缩啊
- 归谜2026-09-23
- Hi-linuxdo2026-09-23
还是V1好,一般晚上或者周末用到50%以下就会送重置卡
- David_Colin2026-09-23
实测上下文尽量不要超过300k,超过之后每轮消耗的token量涨得很快;最好是有意识的把任务分阶段拆分,到达300k左右就开始压缩,compact两三次之后还搞不完的就handoff交接到文件里面开新会话,千万别在超长上下文的会话使劲干,容易跑偏且token消耗飞快,尤其是下午的高峰期。
- 果丹皮2026-09-23
算,感觉差不多400k就应该换会话或者压缩了