- 往事随风k2026-09-27
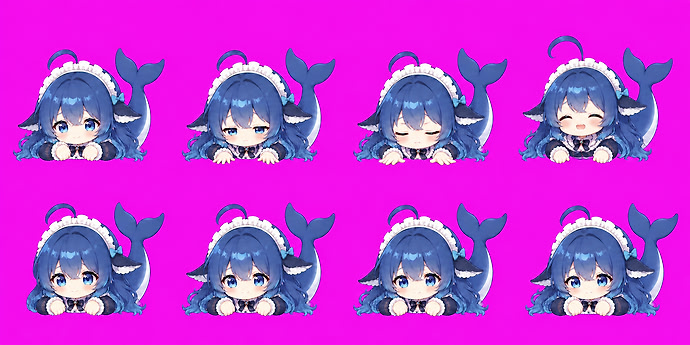
我之前做桌宠动画主要靠AI。先确定好肥鱼的动画动作细节,然后让GPT去写提示词,写好自己把提示词和素材扔给image2.5生成关键帧,最后再交给GPT把所有帧缝起来。用DeepSeek的话说就是:单 Canvas + 离屏整帧原子提交 + 程序化变换,单层 PNG 序列优点是难度低,但是动画的帧数不高,有时候感觉很卡。我自己又没有做动画的能力几乎全得靠生图模型和GPT、DeepSeek。做出来的效果大概如图:
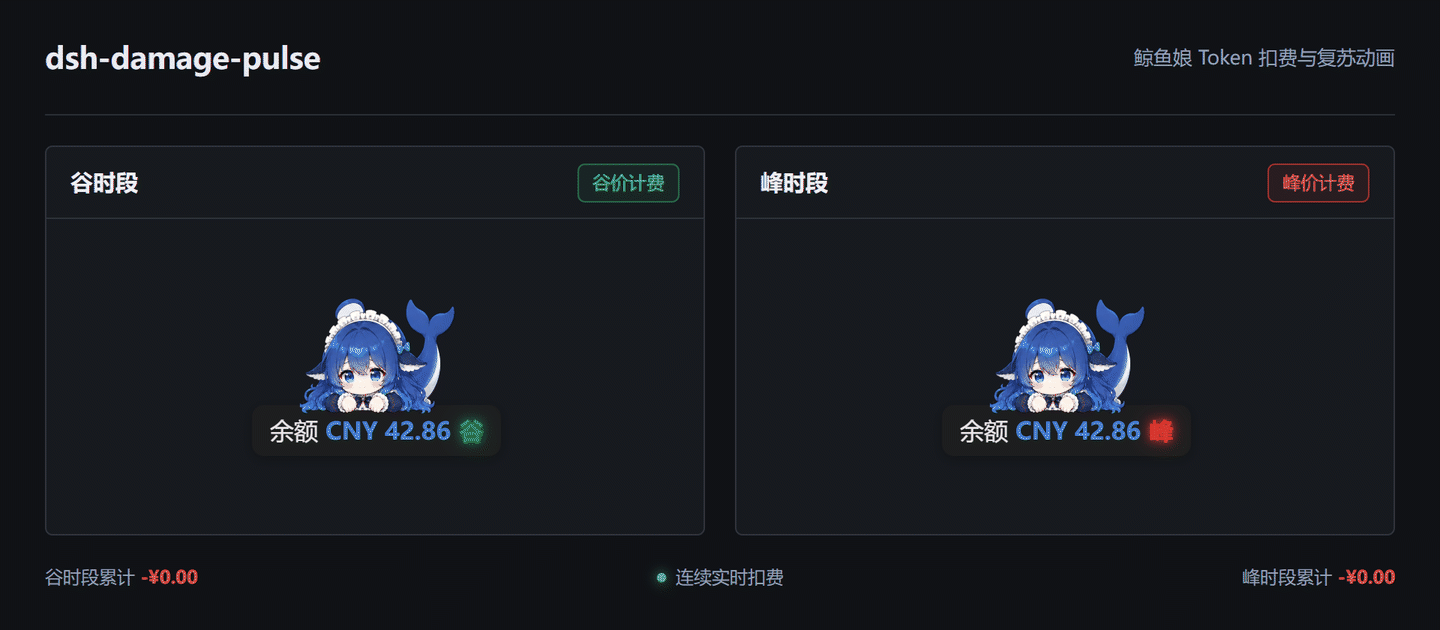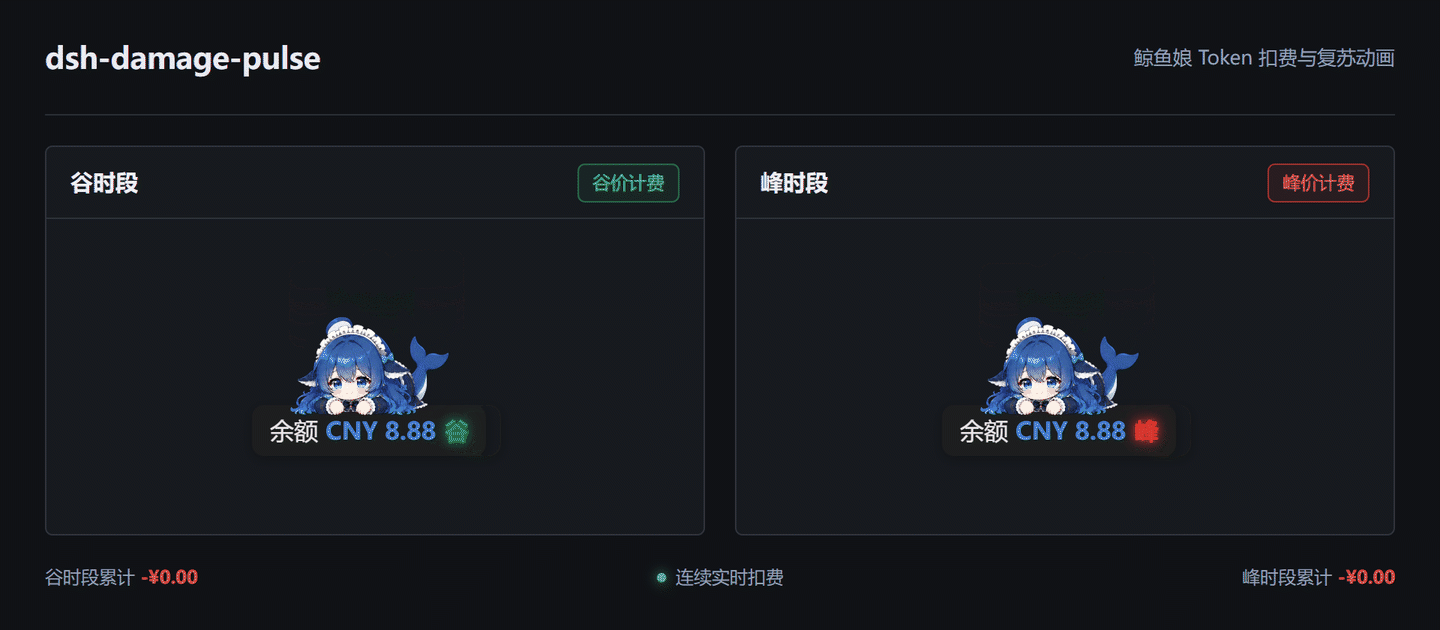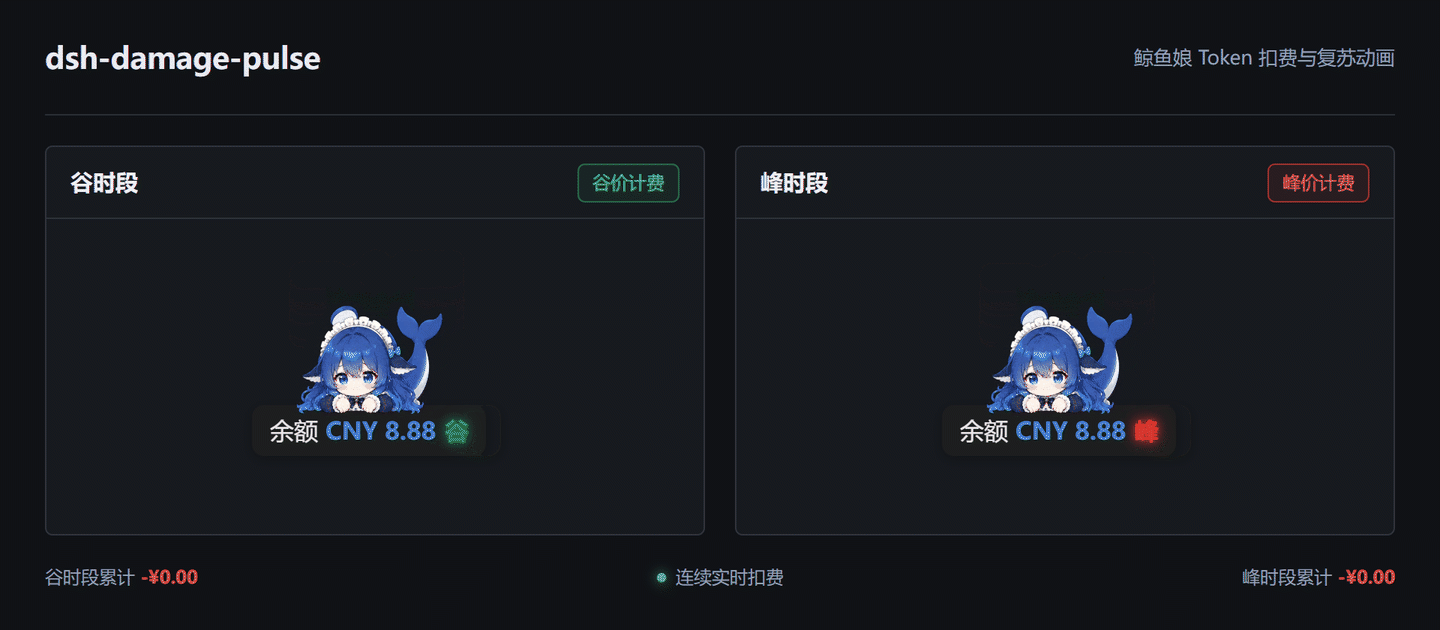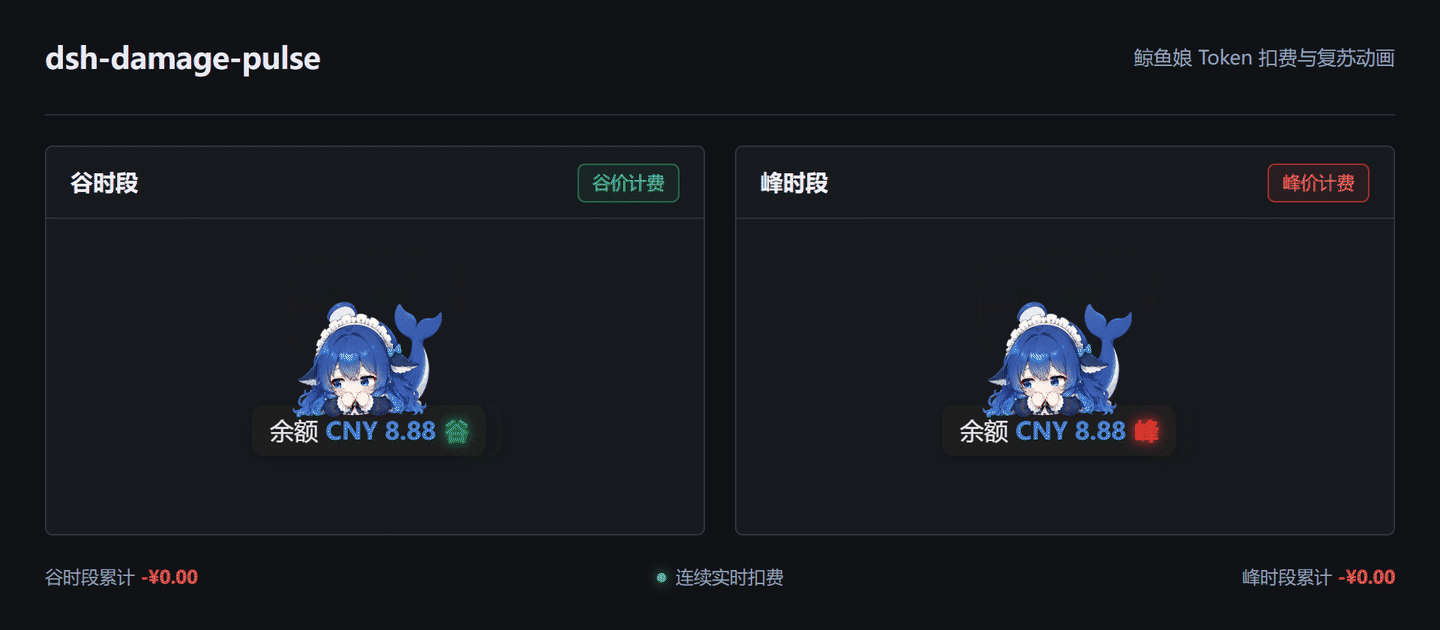
我想看看有没有更好的桌宠动画制作方案,之前让GPT6用PixiJS做过分体动画,但果冻效应太明显,弄了好几天都没解决。
主楼 - 吕相赫2026-09-27
同 等一个“最佳实践”
- lan2026-09-27
动画不太好,要不用视频模型生成,要找动画设计师手绘。
- 往事随风k2026-09-27
- lan2026-09-27
- Xer562026-09-27
godot + gpt 一把梭。
- 往事随风k2026-09-27
我倒是没看到抽搐,可能关键帧太少了,一个动作估计也就画了10帧左右。不过可以考虑一下视频生成然后抽帧
- lan2026-09-27
可以试下,以前做动画 我是需要把部件全部切出来(少的地方还需要自己在手动画补齐来。),然后用godot拼凑好,对接上骨架再做动态。
- Xer562026-09-27
- 往事随风k2026-09-27
那确实很复杂了,我有空试试
- 竹江夕月2026-09-27
关键帧的方法感觉不可靠,一致性很难保证,感觉应该走视频生成的路线,这样动作的连贯性才能保持的比较好
- 往事随风k2026-09-27
之前用image2的时候没发现动作有一致性问题,上面那个GIF就是用image2画的。我一版会先设计好三视图给image2做参考,然后让GPT写提示词的时候严格限制生图模型的动作修改。生成的时候一次生成好几版,让GPT选择偏移最小的一版来用。
- 竹江夕月2026-09-27
我之前做的时候帧数少的时候,image2还可以保持一致性还好但是动作一卡一卡的不流畅,然后像提升帧率就多绘几个动作就会出现中间几个帧人物忽大忽小以及一些形象偏移的问题,后面实在是做烦了,发现视频生成然后抽帧做出来的一致性和流畅性都不错
- 派大星2026-09-27
即梦做视频。然后再抠背景,抽帧。
- Bingrong_LYU2026-09-27
制作skill已经全开源 rullerzhou-afk/pet-forge (mit随便用,两条管线以及踩坑记录都丢进去了)然后我自己这边的话,等忙好这一阵也会增加一批新的主题
可以看一下这位大佬的项目 → @Ruller
github链接:
github.com
GitHub - rullerzhou-afk/pet-forge: A reusable toolkit for building SVG and APNG...
A reusable toolkit for building SVG and APNG desktop pets, with route guides, prompt templates, vectorization tools, animation conventions, and runnable demos.
另外再推荐一下桌宠项目~
github.com
GitHub - rullerzhou-afk/clawd-on-desk: A pixel desktop pet that watches Claude Code,...
A pixel desktop pet that watches Claude Code, Codex, Cursor & other AI coding agents — so you don't have to.