- trigger2026-09-29
配置如图:
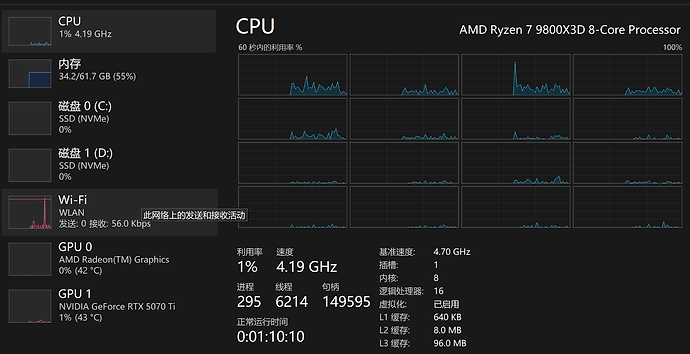
想问问怎么部署才能让模型利用最大化?能稳定的运行
主楼 - 北夜2026-09-29
16g,显存只能部署int4的吧,加上缓存差不多。并发应该不会很多。可以找些ai平台,27b这种都是免费的
- 林澈清鱼2026-09-29
- cknights2026-09-29
4bit都够呛,跑着玩还算凑合,干活就算了
- trigger2026-09-29
目前我是在LM Studio上使用的,模型是qwen3.8-27b-@iq2_m,这个好像是最小的一个模型了
- trigger2026-09-29
是的,最主要还是这两个问题,我现在跑的iq2_m也感觉上下文不够用
- Fsharp2026-09-29
有个极度压缩版的q2,能打平q4,专门为16G显存来的。我在32G的显卡上部署了,我都不用原版q4了,用这个一点智商都不降低,喷token跟窜稀似的。你让你的agent看这篇文章部署就行: PrismML — Introducing Bonsai 2 27B: Near-Lossless Compression in a 9x Smaller Footprint
- derkjohn2026-09-29
16G建议你可以试试用kvmem-v0.16.0-rc3-windows-x86_64-cuda12.9.86项目,部署Qwen3.8-27B-GSQ-RCO-IQ3_S-mtp_3.gguf模型,可以有简单的生产力了
- lopez2026-09-29
16G显存玩不来,即使用gguf Q4_M,也只有10 token/s以下,必定溢出到内存,只能龟速普通问答。要么再Q4往下,会流口水。实际Q4_M,24GB显存,8万上下文,2通道已经快爆了,这是能用的底线。
 bluepost2026-09-30
有免费渠道推荐吗佬,qwen3.8 27b 的