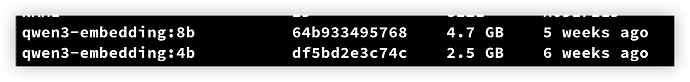- Little_1002026-10-01
如题, 手里有一张p104-100 8g但是也不能空着不用吧, 在想发挥一下余温, 有啥embedding模型推荐没 打算搞搞那种代码库索引的

或者直接用硅基流动免费的 bge-m3? 也不知道速度咋样 ^-^
主楼 - 甘棠2026-10-01
- 枫哥2026-10-01
- Little_1002026-10-01
微信的这个感觉有点大了吧 会不会大体积低质量 ^-^
- Little_1002026-10-01
- cyilin2026-10-01
qwen的那几个模型,挺好的,0.6b的那种甚至cpu都可以
- wintsa2026-10-01
好奇p104的话多少token/s,我现在用12代cpu和核显跑jev的量化第三方模型。7k文字的dom节点7s,图片5-8s
- 甘棠2026-10-01
MMEB Leaderboard - a Hugging Face Space by TIGER-Lab
- 比卡丘2026-10-01
- Little_1002026-10-01
- Little_1002026-10-01
- 83865592026-10-01
这。。。不如小黄鱼出了算了
- vzld2026-10-01
一般都是qwen,这问题应该上reddit的localllm版问
- 蛋蛋2026-10-01
qwen3-embedding-4B,这个我们用这挺好的
- 比卡丘2026-10-01
具体有什么用啊佬?给个思路,我也有个闲置显卡
- 蛋蛋2026-10-01
做语义检索使用的
- apparition2026-10-01