竟然还能这么测模型能力吗???
1212
- NowwwW2026-10-04
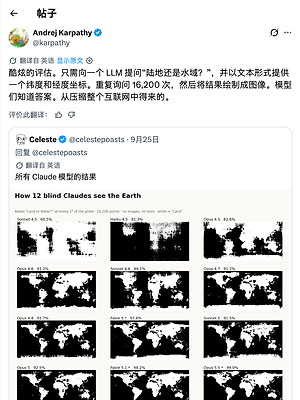
起因是刷到 Karpathy 大佬转载的一篇用“画地球”来测模型能力的帖子,感觉挺有意思的。
方法挺简单的,就是取大量经纬度坐标,挨个问模型“某某某坐标是陆地还是水?”。
然后问 16200 次就可以画出一张模型认为的 ^-^ 地图。
X 截图
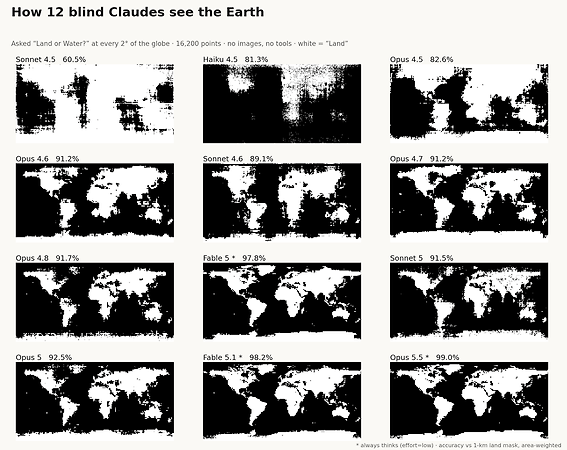
看了看 A\ 家模型的结果,似乎真能测出来些啥?
Sonnet 4.5 和 Haiku 4.5 都拉完了。到 4.6 代之后感觉地图突然就成型了。
Fable 级和 Opus 5.5 又跟其他的拉开了差距。
到 Opus 5.5 基本就是完全复刻了。
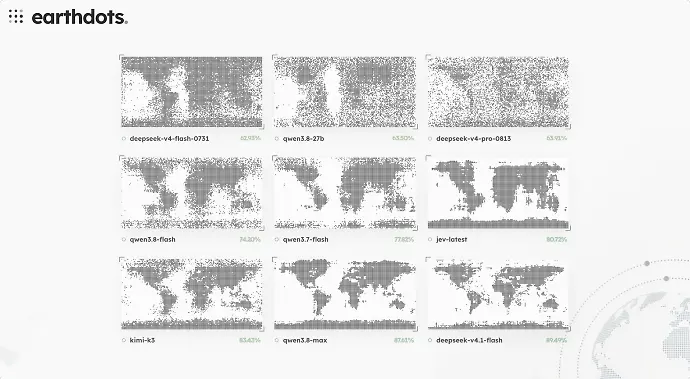
然后自己用百炼的 1M 免费额度测了一些国产模型,还测了下 用不完了发点福利,50000刀jev模型随便用 里面的 jev(感谢佬),测一个大概消耗 0.7 ~ 1.2M token。
deepseek-v4.1-flash 果然真神。从 v4 到 v4.1 变化巨巨巨明显。
其他模型的话,从 kimi-k3 开始基本能看到一些形状了。
deepseek-v4-pro 就基本拉完了,像一坨弄*。还不如 v4 flash。
大家觉得好玩也可以去测测hhh
主楼 - calendar2026-10-04
kimi 这么弱吗?参数大了不少啊 ^-^
- NullUserSIe2026-10-04
这个还挺有趣的,话说有没有画中国地图时候画错的那种模型?我对这个比较好奇。
- Zuojingqi2026-10-04
我有点看不明白这个画的是什么,我有点菜了。。。^-^
 Angel2026-10-04
点阵图画世界地图
- NowwwW2026-10-04
采样一些经纬度发给大模型,问是陆地还是水面,然后就可以画出来啦
- 星渊清梦2026-10-04
这个太吃抽卡了吧,本来模型输出就是随机性的
- NowwwW2026-10-04
原测试好像每一个点会问四次,我直接把 temprature 设 1 而且只问了一次 ^-^
- 疯狂麦克斯2026-10-04
大语言模型输出质量本来不就是看谁猜的更准吗^-^
- Runwhere2026-10-04
opus5.5的表现真吓哭了LOL
- wcac2026-10-04
只要语料的范围够广,这些东西肯定会包含的。有人专门去打卡各个经纬度的整格点,也有网站专门搜集每个整格点的环境状况。这些信息爬虫都会爬取到的。比如这个百度百科
- NowwwW2026-10-04
- 星渊清梦2026-10-04
模型的随机性不在于知识,他预测的下一个token本身就是要带有随机参数进入,如果他恰巧选择了权重低的token那么就不准确了,这也就是为什么原版要测4次的原因,而不是说你知识和语料的问题。。。。。。
