- 时予曦月5天前
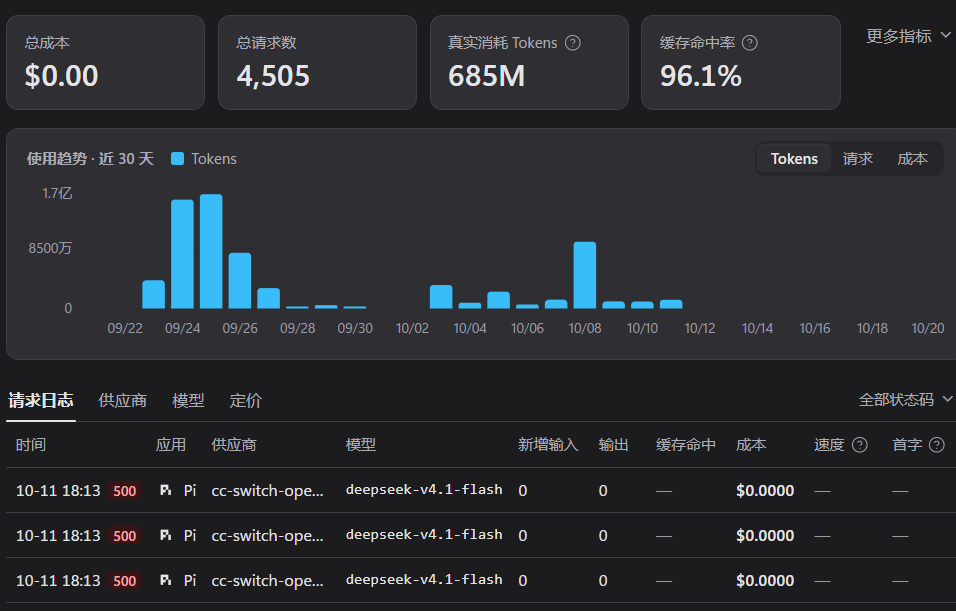
1.deepseek注意力超过256k上下文就会很差,不推荐设置1m上限使用
2.deepseek做那种每时每刻都有反馈的事情还好,但如果要做比如准备训练数据或者训练模型的时候,很容易就不注意相关要求细节就哼哧哼哧做了,关键中途也没什么反馈。我的建议是在 DeepSeek 执行之前先列 Plan 方案,并且让别的模型或你自己审查
3.在让 DeepSeek 做之前,一定要对齐方案,它不是 Claude Opus 5.5超级懂你的存在
DeepSeek 可以作为 GPT 的下位替代(执行),Gemini 可以作为 Claude 的下位替代(规划+审美)。
不要互相混着用,不然你会失望
主楼 - 不二5天前
感觉dsv4.1flash已经好很多了啊
- 星塔旅人5天前
还有上下文问题吗,看来国内 agent 默认 300k 上下文还是有道理的
- Stitch5天前
这两天在dsh里使用,都没有确定方案 大肥雨就自己干起来了 很无语.
- af143c5天前
上下文的问题,现在的模型基本都是这样,像gpt我也是限制272K上下文,v4f我基本作为子代理用,写完让gpt去审查。
 树萌芽5天前
上下文无论现在的大模型多强我都设置500的上限,超过之后不仅慢还巨费token还蠢
- oelove5天前
什么是对齐方案?
- 心尘4天前
别说国内agent,目前来说,目前全球ai都有上下文问题,包括gpt claude也是,推介最佳性能设置300k,如果有些特殊情况,可以考虑400k,400k基本就是极限了
- mingyue5204天前
确实上下文过多会幻觉
- Pandoratobe4天前
这一版本就适合给 oai 当子智能体打工的。思考强度开 Max 或者 High 也行。如果你不急的话,你就开 Max。输出效果都是一流的,无论是搭配 6.1 Sol还是阿斯塔都是。