- 你这是违法行为2026-07-22
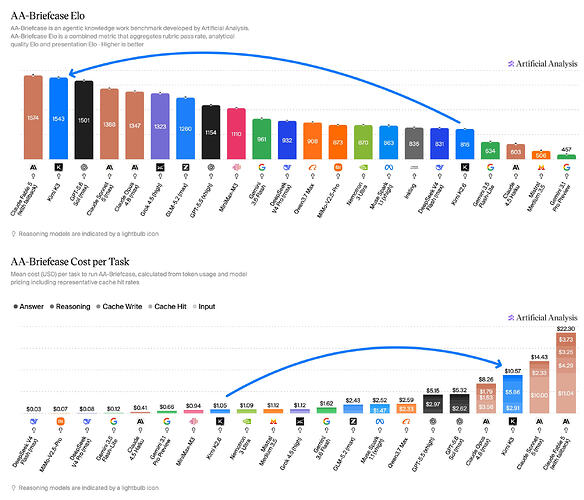
Artificial Analysis 更新 AA-Briefcase 榜单。这个评测让模型从近 2000 份邮件、Slack 记录和公司文件中找信息,再交付表格、演示文稿和界面原型。它共设 4 个长期项目和 91 项保密任务。
Kimi K3 得分 1543 Elo,仅次于 Claude Fable 5 的 1574。它超过 GPT-5.6 Sol 的 1501,也领先 Claude Sonnet 5 和 Claude Opus 4.8。
K3 的客观要求通过率为 51%,Fable 5 为 56%。但 K3 的分析质量得分略高,1754 对 1744。它主要输在成品展示,低于 GPT-5.6 Sol 和 Opus 4.8。
性能提升也伴随着更高的 Token 消耗。K3 平均每项任务花费 10.57 美元,约为 Kimi K2.6 的 10 倍。它平均执行 83 轮,输出 12 万 Token,耗时 56.4 分钟。完成同类任务所需时间约为 Fable 5 的 2.5 倍。
 主楼
- wjy2026-07-22
然而还是比fable便宜啊,但是fable里套餐可用,这样算下来fable反而更便宜吗?
- HuanNan2026-07-22
理论上来说FABLE是最便宜的,长期重型任务里,FABLE可以用最快的速度和最少token去完成,不过很明显算这个帐还是太贵了
- 爱吃番茄2026-07-22
全部换算下来性价比最高还是5.6 sol ?我看了下分数差距不大,但是钱差老鼻子远了
- wzy12026-07-22
kimi 确实是很慢了,而且确实存在一定差距,
- 长头长尾小龙人2026-07-22
我现在用 Opus 明确需求之后,让 Fable 规划,然后再用 Opus 执行,只让它介入中间的一步,但是准确率大幅提升,几乎没有返工。
- Ash2026-07-22
用算力、时间成本和堆步骤换来的智能
- chenanning2026-07-22
都一样的,fable、5.6也是更大体积更大算力
- ba_lao2026-07-22
gpt 5.6可惜了,如果不是因为猎奇分词器,实际成绩还要好点。