- xwy-python2026-07-28
如题,我相信这是一个大多数深度使用 GPT 进行 Vibe Coding 的人都会遇到的问题,我相信各位大佬有成熟的解决方案,故来求教
由于 claude 最近封号相对剧烈,本人正价代充的 Claude 账号被封,被迫从 Kimi K3,GPT 5.6,等一众第一梯队模型中选择一个性能相对不错的模型来进行接下来的开发,顺便配置到我自己的Agent 中,说个题外话,当我看到 Kimi K3 的 API 价格的时候,我真的震惊了,未缓存命中的输入是 20 人民币每 M,输出是 100 人民币每 M,缓存了的输入都有 2 人民币每 M,相当于中转站 1 元一刀的 CC Max 中的肥波 5 的二倍,突然发现国内第一梯队模型也用不起了(官方订阅还在预约)
所以剩下可用的模型里,GLM 又完全没有视觉,思来想去,竟然只有 GPT 5.6 可用
官方 key 肯定是用不起的,倒是 Code X 的 API 看起来性价比极高,价格又低,价格波动范围又不高,每家中转基本上都会有一个,甚至还能自己建号池。
但是有一点很不好,就是之前的 GPT 5.6 还能有 372K的上下文长度,现在就只剩下 258K,很难想象 code x 中只有 258 k,动不动就上下文压缩长任务漂移严重的 GPT5.6 和 Openai 宣传中的那个自主长时间工作攻破拥抱脸的 GPT 五点六是同一个模型
由于这个上下文长度的痛点已经痛到了一定程度,所以我寄希望于论坛的大佬们有完美的解决方案,最好是一个类似于 Code X Pro Max 版的开源项目 能够从架构层面解决这个上下文的问题,比如做索引,更改压缩逻辑 或者更合理的上下文工程之类
总而言之,救救孩子吧!
现在 Code X 的 GPT 5.6 根本无法完成大型项目的开发,尤其是那种,并非所有功能都可以直接通过跑测试验证的项目,比如我正在做的 Agent,GPT 5.6 这点可怜的上下文简直是灾难性的,好不容易让 GPT 5.6 完我的项目文档,明白我的理念,然后再让它去读完整个项目代码,然后刚打算跟 GPT 5.6 说这里打算实现什么新功能,就会出现压缩上下文
然后我就只能无助地看着
上下文已自动压缩
每当这个时候,我都无比怀念 Claude Code 的 1M
然后只能急头白脸地把自己所有要说的话全都说在目标模式里,并且引用无数个文档(请你先读完我们的设计总纲,然后再阅读哪哪哪部分的代码。最后请按照这个文档里的思路实现这个功能。注意不要删除我之前的数据,注意推送到生产环境之前,必须检查有没有简化实现…我们的项目文档在这个位置,我们的 API 文档在这个位置,我们这个项目实际使用的模型是这个,然后之前这个模型有什么问题,所以不要改变我的工具调用格式,不要回退到原生工具调用格式 …),然后祈祷 GPT 5.6不会做出违反我项目文档的窒息操作
所以究竟有没有一个项目优化一下 GPT 5.6 这个上下文工程的逻辑,把我从这个“永远不知道模型知道什么,不知道什么,以及模型会干出什么雷霆操作”在怪圈里拯救出来呀
主楼 - Linus_Torvalds2026-07-28
- HitC2026-07-28
个人感觉258K的上下文是足够的
超过300k的上下文,模型的准确性会大幅下降。而且成本暴涨。意义不大
200-300K的上下文是大量实践总结出来的最好长度
现在 Code X 的 GPT 5.6 根本无法完成大型项目的开发,尤其是那种
这个我感觉并不正确。我开发20w+行的编译器用5.6 terra效果都很好
然后只能急头白脸地把自己所有要说的话全都说在目标模式里,并且引用无数个文档(请你先读完我们的设计总纲,然后再阅读哪哪哪部分的代码。最后请按照这个文档里的思路实现这个功能。注意不要删除我之前的数据,注意推送到生产环境之前,必须检查有没有简化实现…我们的项目文档在这个位置,我们的 API 文档在这个位置,我们这个项目实际使用的模型是这个,然后之前这个模型有什么问题,所以不要改变我的工具调用格式,不要回退到原生工具调用格式 …),然后祈祷 GPT 5.6不会做出违反我项目文档的窒息操作
对于这个,我感觉主要还是要学会更高效的用AI
- marre2026-07-28
语言好混乱呀,这个上下文逻辑没办法优化吧,只能靠人和文档去干涉,或者看看 workflow 吧。
- 二木2026-07-28
- lee2026-07-28
相信这是一个大多数深度使用 GPT 进行 Vibe Coding 的人都会遇到的问题,我相信各位大佬有成熟的解决方案,故来求教
由于 claude 最近封号相对剧烈,本人正价代充的 Claude 账号被封,被迫从 Kimi K3,GPT 5.6,等一众第一梯队模型中选择一个性能相对不错的模型来进行接下来的开发,顺便配置到我自己的Agent 中,说个题外话,当我看到 Kimi K3 的 API 价格的时候,我真的震惊了,未缓存命中的输入是 20 人民币每 M,输出是 100 人民币每 M,缓存了的输入都有 2 人民币每 M,相当于中转站 1 元一刀的 CC Max 中的肥波 5 的二倍,突然发现国内第一梯队模型也用不起了(官方订阅还在预约)
所以剩下可用的模型里,GLM 又完全没有视觉,思来想去,竟然只有 GPT 5.6 可用
官方 key 肯定是用不起的,倒是 Code X 的 API 看起来性价比极高,价格又低,价格波动范围又不高,每家中转基本上都会有一个,甚至还能自己建号池。但是有一点很不好,就是之前的 GPT 5.6 还能有 372K的上下文长度,现在就只剩下 258K,很难想象 code x 中只有 258 k,动不动就上下文压缩长任务漂移严重的 GPT5.6 和 Openai 宣传中的那个自主长时间工作攻破拥抱脸的 GPT 五点六是同一个
说起来cursor上面的gpt不是可以选1M上下文 就是不知道好不好用
- 空城2026-07-28
可以使用cursor++ 呀在里面使用5.6 配置1m上下文
- lee2026-07-28
为啥我回复老是会引用上啊 我感觉我也没选中么
- Blade.Melina2026-07-28
codex的压缩能力很强; 设计自己的工作流渐进式读取, 别全量读代码文档; 考虑下知识图谱类工具; 你的场景还是说清楚点, 一般不存在你说的无法开发大项目的情况;
- xwy-python2026-07-28
我认为不太一样,像编译器这种东西,几乎可以通过写测试用例之类的方式,也就是先写测试,再写代码这种形式,基本上不会导致有偏移,有偏移跑一下测试就好了,但是我们做 Agent 架构,就是做自主 Agent 以及 AI工作流之类的,尤其是自主 Agent,其实 AI 的反应是不可预期的,这就导致没有办法通过可验证的测试来保证代码和提示词工程没有问题,之前试过先写测试后开发,结果几百个单元测试也只能保证代码层对于预期输出的处理是没有问题的,但是一旦提示词和代码层配合不好,就会有问题,而这种问题光靠写测试之类的可验证的方法是搞不定的,这就导致了,如果模型获得的信息不够完整。某一部分的实现有问题,它自己不能及时地发现,并且正常修复
- 凌风神舞2026-07-28
这个是不起作用的, OAI的源头限制了, 想要1M的上下文, 得使用他们家的API, 之前就是超272的上下文会更贵, 就回退到272.
- Pepper2026-07-28
没什么好办法,只能多写点引导文档,然后让codex读代码的时候少读点了
- bfloat162026-07-28
这玩意不是可以自己改吗,反正只要不超过353k官方codex订阅都是支持的
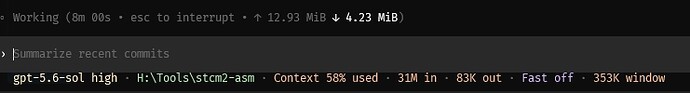
另外如果你用的是中转,记得开远程压缩,这玩意能把cc吊着打```
[model_providers.example]
name = "OpenAI" #注意大小写,写OpenAI就是开远程压缩
wire_api = "responses"
requires_openai_auth = true
experimental_bearer_token = "sk-xxxxxx"
base_url = "https://example.com/v1" - 空城2026-07-28
噢噢 那应该是我用的gpt官方api
- CC-linuxdo2026-07-28
codex的上下文压缩已经很强了
- Mar5h4ll2026-07-28
mark一下 现在还是写文档 看看佬们有无其他方法 ^-^
- 神净2026-07-28
没太理解为什么要读整个项目的代码,你自己开发也不会把整个项目的代码都读一遍吧,大致的架构理解了就行,具体开发哪块再指清楚,怎么会上来就上下文压缩的
- 忘忧君2026-07-28
远程压缩是什么?有什么好处么?还没用过这个功能,佬能解释一下么?
- bfloat162026-07-28
- FFFFFFFFFir2026-07-28
可以看看Graphify这种工具,兴许会有帮助