- chez2026-07-30
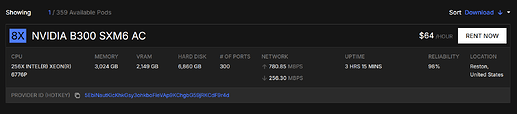
lz 近日捡了一台B300八卡。遂尝试部署 kimi-k3,试过 vllm 和 sglang。vllm 的比较稳定,sglang 的在上下文达到 14w 的时候会报 context overflow 的错误,可能是 manba 的空间没有预留好。而且 sglang 的 Dspark MTP draft,训练长度 ≤ 4096,在长上下文的情况下性能不好。

先是安装 vllm。注意,官方的 nightly 预编译版只有 aarch64 架构的支持,只支持 GB300/GB200 ?所以在 amd64 架构 的 8xB300 上,需要手动编译。用 vllm 的 kimi-k3 分支。
这里还需要打两个补丁
- flashinfer-python==0.6.15.post1,里的 ActivationType 里没有 Situ。Kimi-K3 的 MoE 用 SituGLU 激活。需要自己去编译 flashinfer 打了 SituGLU 的 PR。
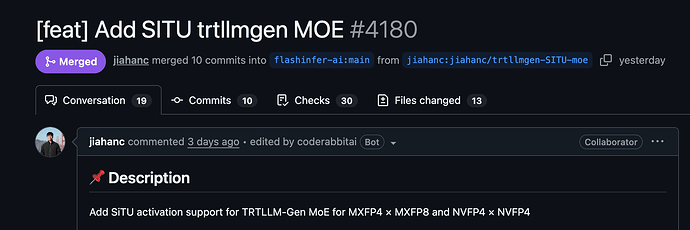
- 给 vllm 接上 is_private,即使 enum 里有 Situ,flashinfer 的 trtllm kernel 也只在
#ifdef TLLM_GEN_LOCAL_CUBINS_ABI里处理它,否则运行时报错,需要在调用 Situ 的地方 加 is_private= True 参数。自用,并发开的不高的话,也不需要 lmcache,所以就没有加,LMCache 目前还处理不了 KDA 的混合缓存布局,等待适配,在 tp=8 时, mamba hidden state 是可切分的,然而 MLA latent KV dim 不可切分。
启动参数如下,注意,如果不加 top_p=0.95 的话,因为 vllm 的 Dspark 是在 temperature=1 top_P=0.95 下训练的,不加的话,由于 huggingface 提供的权重,generated_config.json 里没有 top_p 参数,vllm 会默认使用 top_p=1.0,导致 MTP accept length 只有 1.x 。```
vllm serve "$MODEL" \
--served-model-name moonshotai/kimi-k3 \
--host 0.0.0.0 \
--port "$PORT" \
--trust-remote-code \
--load-format fastsafetensors \
--moe-backend auto \
--gpu-memory-utilization 0.95 \
--tensor-parallel-size 8 \
--no-enable-flashinfer-autotune \
--max-model-len 1048576 \
--kv-cache-dtype fp8 \
--attention-config '{"use_prefill_query_quantization":true, "mla_prefill_backend":"FLASHINFER"}' \
--enable-prefix-caching \
--enable-auto-tool-choice \
--tool-call-parser kimi_k3 \
--reasoning-parser kimi_k3 \
--max-num-seqs 32 \
--override-generation-config '{"top_p": 0.95}' \
--speculative-config "{\"model\":\"$DRAFT\", \"num_speculative_tokens\":7, \"method\":\"dspark\", \"attention_backend\":\"FLASHINFER_MLA\", \"draft_sample_method\":\"probabilistic\", \"rejection_sample_method\":\"block\"}"
```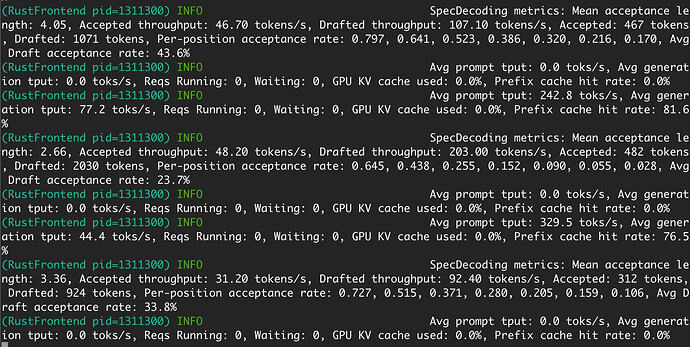
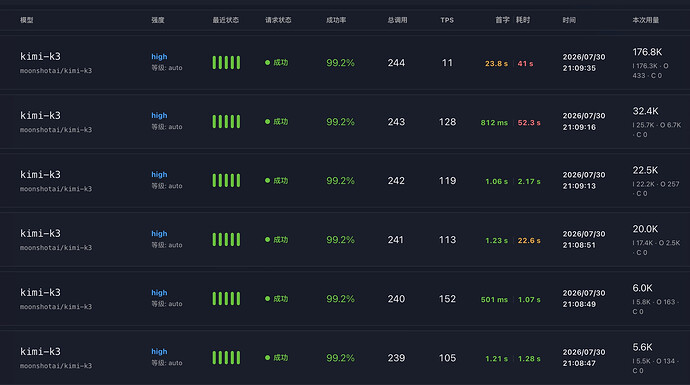
速度感觉还可以,自部署的话,性能比 glm 5.2 慢 1 倍,但也够用了。
 主楼
- linus2026-07-30
哪里捡的能告诉我一下吗,我也去捡一台。
- 行思渐远2026-07-30
你们是转载吗?白天看到一个相似的
- kumaxs2026-07-30
财力还是技术力,一时不知道该羡慕哪一个
- MIKU-linuxdo2026-07-30
- sulfite53072026-07-30
- 芙兰朵布丁2026-07-30
请问下是哪里捡的,明天我也去瞅瞅
- well2026-07-30
- yuyumaster2026-07-30
- 水很深2026-07-30
- kooer2026-07-30
我准备跟着楼主走,说不定还能捡到一台
- artisan2026-07-30
- ceshi01Adx2026-07-30
这么牛叉吗?8*b300你怎么弄到的?几千万了吧..
- 地狱之歌2026-07-30
能自己部署K3的 都是大佬 钞能力无敌
- lkainan2026-07-30
Linux的站内贫富差距怎么越来越大了啊
- nickchan2026-07-30
我掉的,都给你玩过了,现在可以还给我了吧
- 初春饰利2026-07-30
哇
[image]
[image]
当底层群友的想象力还停留在 H100 的时候,隐藏的天家群友来让底层群友看看 天上宫阙 了。
2022 年发布的 Hopper 架构 在日新月异的算力需求面前已经不行了!
现在这个时间点(2026年4月),对于各大厂(微软、Meta、谷歌)来说,B200(属于 Blackwell 架构)确实是目前能大批量部署并交付的最强 AI 算力卡了!
而且,以前要… - hh_2332026-07-30
压测TPM能有多大,直接TP8还是太奢侈了,什么时候token平台也能有这么快的速度 ^-^
- Turing2026-07-30
- hh_2332026-07-30
蒙古有GPU渠道? ^-^不会是说的内蒙古吧,有一些抢占式平台价格更便宜一丢丢