- made_jace2026-01-06
1 省流总结
站内有许多前辈分享过电子书资源下载总结帖,无私伟大且资源丰富的网站如 Z-library 数字图书馆、安娜的档案,国内也有读秀、超星、图书馆参考咨询联盟等。
就英文书而言,最近 10 年出版基本能从上述网站找到高清PDF电子版或扫描版,但存在部分书目仍无法找到或者扫描质量较差(如黑白扫描、阴影严重、字体模糊)等问题。本文介绍从互联网档案馆(Internet Archive)下载电子书作为补充。 一个绝妙的网站互联网档案馆【archive.org】 - 资源荟萃 - LINUX DO
截至2026年1月,网站书籍与文本约 4800万件,包括公共领域经典作品、古籍数字化以及 Open Library 现代书籍等,电子书特点是扫描仪人工高清扫描版,注册账号后支持在线阅读、借助浏览器插件可实现免费借阅下载。
被遗忘的免费书库:互联网档案馆(Internet Archive) https://archive.org/ 注意国内IP无法访问。
Chrome、Edge、火狐浏览器均可在插件商店搜索 Internet Archive Downloader (绿色方块图标),点击借阅书籍可以预览后下方会多出下载按钮。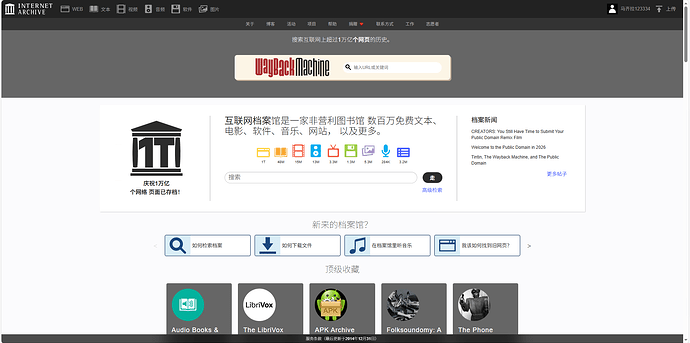
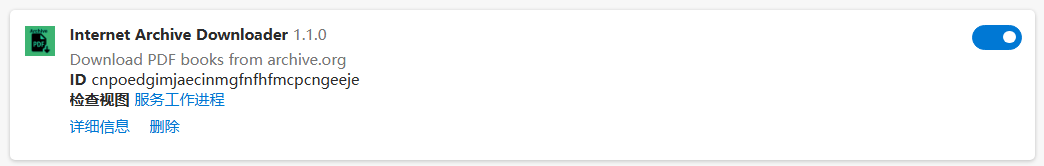
火狐浏览器插件下载 Internet Archive Downloader – Get this Extension for 🦊 Firefox (en-US)
Edge浏览器插件下载 Internet Archive Downloader - Microsoft Edge Addons
2 缘由
最早知道这个网站还是在很久之前何同学介绍 Mac 历史的视频里,那时百度、谷歌的网页快照功能也还在,只知道这是一个可以回溯浏览历史网页的网站。
偶尔在资料的失效超链接里面会想起来它,比如一个页面 url 现在被完全重定向了或者网页内容发生了大的变化;再比如要下载一些历史版本的软件但现在只有最新版本,回到过去的网页或许超链接还有效,对其他功能知之甚少。
本人有一本英文技术书一直想下高清PDF版本的,Z-library和安娜全网下下来的全部是黑白模糊扫描版的很影响阅读,实体书各大图书馆也没有,在亚马逊平台下到样章是彩色PDF版本的,所以一直心心念念着。最近巧合之下再次搜索到互联网档案馆发现这本书,虽然是扫描版但是是彩色的质量还不错,很快找到了下载方法。又搜索资料更加了解了下这个网站,不禁肃然起敬,有感而发,整理相关资料一并分享给大家!
补充:本人下载电子书用的比较多的网站安娜的档案、Z-library 数字图书馆,如果IP限制了就换个节点,或者使用 cloudflare 的 warp 软件。
站内检索到:
Z-library最新地址及共享账号
zlib.pro
Zlibrary 地址 | Zlib 检测
Zlibrary最新地址,Z-Library最新,Zlibrary共享帐号 ,Z数字图书馆。搜索书籍。免费下载书籍,Zlibrary,Zlibrary入口,Z-Library. Download books for free. Find books
Z-library镜像
zlib.wwwnav.com
Z-Library入口网站,zlibrary镜像网址.客户端下载(2026更新)
zlibrary 是一个全球最大的免费电子书和学术期刊资源平台,被誉为“世界上最大的免费图书馆”,超过23,000,000书籍和84,837,000学术文章,涵盖知名文学著作,小说,理工学科,人文艺术,以及学术论文等应有尽有
book.clouds.pp.ua

电子书最新地址
获取Z-library(Zlibrary)最新地址、镜像站点、客户端下载,支持多语言,安全稳定,全球和中国均可访问。
安娜的档案馆
weblib
3 使用方法
3.1 浏览器插件下载
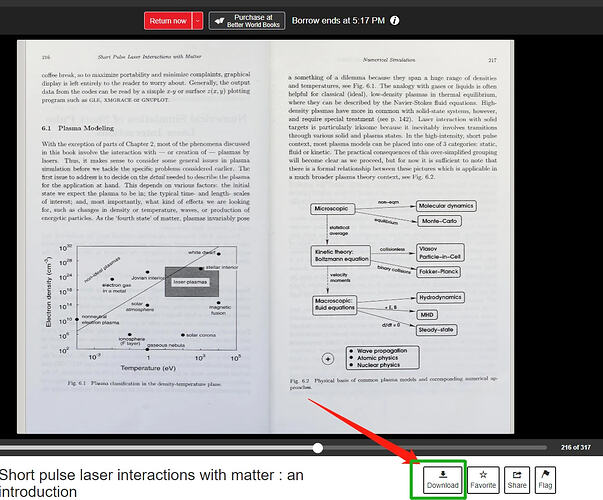
之前在bilibili也有人发过Internet Archive 网站电子书下载方法。对于科研人员来说,下载国外学者的专著是日常必备技能。在网站注册账号登入后,检索到书籍,需要先借阅(有1h和14天,点击1h即可),下完后及时归还,点击 return Now。因为书是一次只能借一个人的,避免给后面其他需要的人添麻烦。
Chrome、Edge、火狐浏览器均可在插件商店搜索 Internet Archive Downloader (绿色方块图标),点击借阅书籍可以预览后下方会多出下载按钮。如果网络不方便或者其他浏览器可以搜索从其他镜像插件商店下载。
3.2 python脚本下载
也可通过 Python 脚本下载,但是本人没试过,有待验证,用上面插件挺方便的。
github.com
GitHub - jamessucla/archiveripper: Download borrowed books from archive.org
Download borrowed books from archive.org

GitHub
GitHub - MiniGlome/Archive.org-Downloader: Python3 script to download...
Python3 script to download archive.org books in PDF format - MiniGlome/Archive.org-Downloader
4 网站介绍
据维基百科介绍 互联网档案馆 (Internet Archive)是一个成立于1996年的非营利性数字图书馆,由Alexa创始人、计算机科学家布鲁斯特·卡利(Brewster Kahle)创立。其总部坐落于美国加州旧金山里士满区一座由古希腊式教堂改建的建筑内,象征着对知识永恒保存的追求。致力于“为所有人提供知识的便捷访问” universal access to all knowledge。卡利的愿景是建立数字时代的“万物图书馆”,旨在为全人类提供免费的知识访问,防止数字文化遗产在技术迭代与内容更迭中湮灭。近三十年来,互联网档案馆如同一艘“数字方舟”,系统性地保存着互联网的集体记忆。其最著名的服务“时光倒流机器”(Wayback Machine)自2001年推出以来,已不仅仅是简单的网页截图工具,它保存了网页的完整技术架构(包括HTML、CSS、JavaScript代码),以便真实“重现”历史页面。这项服务对于学者、记者和公众追溯历史信息至关重要。截至2025年10月,Wayback Machine存档的网页数量已突破 1万亿 个,标志着人类保存数字历史的一个里程碑。 是全球最大的免费数字图书馆。
浩瀚馆藏,一座在线文化遗产宝库。互联网档案馆的收藏远不止网页,它构建了一个覆盖多媒介的庞大数字资源库。根据其公布的数据,主要收藏规模令人惊叹:
- Wayback Machine:超过 1万亿 个网页存档。
- 书籍与文本:收录了数千万册图书和文本,包括大量公共领域著作和通过合作扫描的珍贵资料。
- 音频、视频与图像:保存了数百万部电影、视频、电视节目以及音频文件(包含大量现场音乐会录音)和图片。
- 软件与游戏:致力于保存濒临消失的数字软件和游戏,例如在Flash技术退役时,通过模拟器保存了数万部经典Flash内容。其收藏还包括数千款MS-DOS游戏和复古掌机游戏。
- 教育资料:提供美国大学课程视频与文字材料,堪称在线教育资源的先驱之一。
核心服务与项目,互联网档案馆通过多个项目向公众提供免费服务:
- Wayback Machine(网页时光机):用户可输入网址,查看该网站自被收录以来的所有历史快照,是研究网络演变、核实历史信息的核心工具。
- 开放图书馆(Open Library):这是一个创新的数字借阅系统。对于仍在版权期的书籍,互联网档案馆模仿实体图书馆的“一本一借”模式,即拥有的数字副本数量有限,借出后需等待归还才能再次借阅。然而,这项服务也引发了重大版权争议(见下文)。
- 多媒体档案馆:提供海量的音频(如现场音乐档案)、视频、图像和软件的直接访问与下载,许多资源支持在线播放或模拟运行。
- Archive-It:一项为图书馆、档案馆等机构提供的付费定制化网页采集与存档服务。
- 特色收藏:如“掌机历史合集”、黑胶唱片数字化项目等,专注于保存特定领域的数字文化遗产。
挑战、争议与社会影响,互联网档案馆的崇高使命在实践中面临着巨大挑战:
- 版权诉讼:2023年3月,美国法院裁定其“开放图书馆”项目的数字图书借阅模式侵犯了四家主要出版商的版权。这场诉讼导致超过50万本受版权保护的书籍从其数据库中移除。创始人卡利痛惜地表示,这场胜利的诉讼“摧毁了图书馆”,让“世界变得更愚蠢了”。
- 运营压力:作为完全依赖捐赠的公益组织,其运营时常面临资金压力。2025年4月,因美国政府预算削减,其一项重要资助被中断,对信息自由访问构成潜在威胁。
- 技术挑战:随着人工智能生成内容的泛滥和更多信息被置于付费墙之后,如何有效保存和界定“真实”的网络历史变得愈加复杂。
- 安全事故:2024年9月,曾发生数据泄露事件,导致数千万用户信息被盗。
Internet Archive 互联网档案馆在加州的三个城市设有资料中心,分别为旧金山、红木城和列治文。为减少数据丢失的风险,在包括埃及的新亚历山大图书馆和阿姆斯特丹等地储存有存档副本。尽管面临诸多困难,互联网档案馆的社会价值得到了广泛认可。2007年,它被加利福尼亚州指定为官方图书馆。2025年,旧金山市宣布10月22日为“互联网档案馆日”,以表彰其贡献。它不仅是研究者、历史学家的宝贵资源,也成为了普通公众缅怀网络过去、探索数字文化的公共空间。
Internet Archive 互联网档案馆完全免费开放,靠捐赠维持运营。无论你是查找已消失的网页、阅读绝版书籍、听历史音乐,还是玩复古游戏,这里都是宝藏。
如果您想进一步了解可观看下面视频:
彩蛋在教堂的展览柜上你甚至能看到中文的奖状证书
bilibili 去了这个“复制”整个互联网的地方,竟是在教堂里?
bilibili The Internet Archive 工作流程
bilibili PBS新闻报道
bilibili 怎么看互联网档案馆被黑客攻击
youtube Can the Internet Archive save our digital history? | BBC News
Inside the old church where one trillion webpages are being saved
From CNN: Inside the old church where one trillion webpages are being saved | Internet Archive Blogs
5 个人体会
电子书对我的意义,我相信真正热爱和需要阅读书籍的人,在经济能力允许范围内肯定是更愿意纸质书的。但是个人还是需要电子版原因是:
- 首先电子版阅读比较伤眼睛,跳转翻阅和记笔记也不方便,很大可能下载了也不会再仔细看,但是难免需要查阅,这是电子版的便携性所在;
- 其次正是因为纸质盗版书的猖獗,才需要提前下载看看以把握质量,确认是否值得购买。对于盗版的专业教材和技术书籍本人也吃过大亏,这不仅仅是盗版阅读体验上的问题,有些书籍在符号、字母、数字上的错误,如果没有正版的对照根本发现不了,对于一个初学者而言不仅仅是误人子弟,更加磨灭的是学习的热情。
面对数字千年版权法,既有像 Z-library 和安娜、Sci-hub 这样的盗火者,也有像 Internet Archive 互联网档案馆从互联网出生到爆炸数十年如一日归档记忆的西西弗斯,当然不乏攻击 Internet Archive 撒旦俄罗斯黑客,而他们最不应该做的是攻击文明本身。存储介质更叠带来便捷的同时也更加脆弱,个人在历史长河中如沧海一粟,而文明是永恒的。
Internet Archive 互联网档案馆远不止是一个存储数据的硬盘,它是一项对抗数字遗忘的宏伟社会实验,是互联网记忆的实体化身。在信息转瞬即逝的时代,它坚持着“普及所有知识”的初心,为后世保存着这个时代的数字足迹。无论你是想查找一个已消失的网页、阅读一本绝版书、聆听一场历史演唱会,还是体验一款古老的软件,互联网档案馆都像一座永不关门的灯塔,守护着人类知识的边界。
Internet Archive 互联网档案馆的创始人布鲁斯特·卡利谈到,创建这个项目的动机来源于公元3世纪末毁于战火的,世界上最古老的图书馆之一——亚历山大图书馆。看着访谈视频中他神采奕奕和到访的参观者介绍教堂里陈列的服务器、志愿者塑像,还有后台的扫描仪工作流程…从青年到满头白发,Internet Archive 经历了火灾、经历了黑客攻击炸弹威胁、经历了出版商版权诉讼、恐怖分子宣传利用与国家安全名义介入…年纪越大越容易被这些纯粹的理想和事业所打动,由衷感谢 Internet Archive 档案馆还有志愿者,正如博尔赫斯所说:“如果有天堂,那一定是图书馆的模样。”该网站的更多功能期待大家发掘!
主楼 - 坠入星河2026-01-06
感谢佬友分享
- topsage2026-01-06
安娜不是废了
- 江晚风2026-01-06
感谢佬友汇总
- edawrz2026-01-06
感谢分享
- Canvson2026-01-06
感谢分享
- 大帅哥2026-01-06
感谢大佬
- JerryXu2026-01-06
互联网档案馆真不错,他的时光机也很nb。感谢楼主分享。
- fluchio2026-01-07
- 萧瑟2026-01-07
又学到了,谢谢佬友
- XS2026-01-31
- 墨入夜色2026-01-31
感谢佬友分享
- duhuyang2026-01-31
支持大佬
- 我爱吃番茄2026-02-04
感谢感谢
- Rhine2026-08-16
感谢佬友无私分享,感谢感谢~,标记收藏
- Mastar2026-08-16
感谢分享,现在只靠搜索想找资源太难了,学习一下
- s11112026-08-16
感谢佬友无私分享,感谢感谢~,标记收藏