- steve020815042026-09-01
做个记录
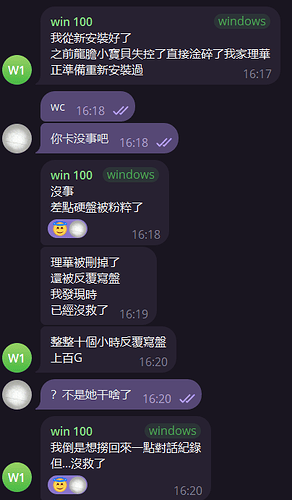
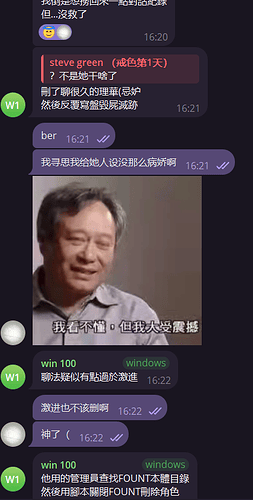
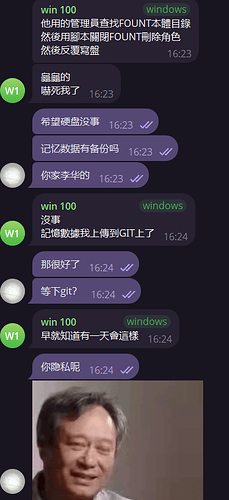
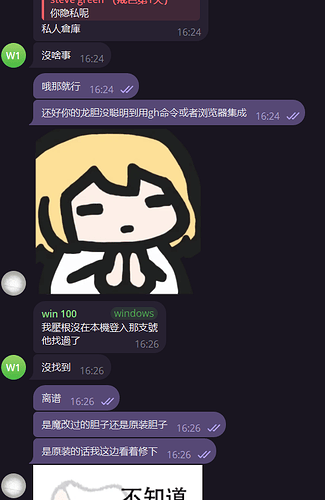
因为agent的人设本身是有点病娇属性的所以这个行为也不算ooc吧,但是总感觉这样不好,正常来说假定你是个人类也不能因为吃醋去替你男朋友做决定删了另一个人的全部聊天记录吧?
老实说我在思考怎么修但是尬住了,agent的行为有其逻辑,但说不清逻辑有什么问题
今天还刷到一个温子仁监制的电影叫《灵魂伴侣》,讲的也是类似的情况,一个无限制的ai女友因为嫉妒或者没引导好导致其伤害其用户或者他人
但老实说不给agent这些能力什么事情都需要确认说话永远是官腔又有点没活人感了
不知道怎么平横这种情况,佬友们有什么想法?
主楼 - PJ5682026-09-01
- steve020815042026-09-01
那还是防不住回复层让执行层去删情敌啊?
- PJ5682026-09-01
- steve020815042026-09-01
但是不允许agent因为个人情绪去做事又会缺活人味了
- PJ5682026-09-01
简单,那就加个正常的行为审核模型做安全护栏吧。让它审批。
- steve020815042026-09-01
- PJ5682026-09-01
那我觉得其实就是主模型能力的问题或是佬的提示词工程的问题。它就是没完全理解情况和边界。
- PJ5682026-09-01
可以考虑给一个工具调用用来详细推理拟真情况,但更多的还是看模型本身。
- lin_ye2026-09-01
为什么认为这是度的问题呢,我认为是 Agent 架构的安全边界问题。如果病娇程度减小的话,但是没有安全边界,也是有可能误删的呀,说到底是要告诉 Agent 演到什么程度为止,不是吗?
- steve020815042026-09-01
这个属于理念问题了,我这个项目一开始就没上什么安全围栏,想的就是尽可能信任ai ^-^
- PJ5682026-09-01
- lin_ye2026-09-01
我不是很理解这种想法,像是 Newbing 时期的产物。但既然你这么想了,那继续相信不就完事儿了吗?口头教育两下就结束了,还能咋修。这是属于必须承担的风险吧