- cjkcjkcjk6天前
预算三万内,最高不超过五万。
求大佬推荐机器型号和配置 🙏🏻主楼 - luodan6天前
RTX 6000 48G *8, 免强能跑 4.1, context 只能稳定在 256K
- JerningChan6天前
哈哈哈哈,那可以跑个 qwen3.8-27b 4bit 量化。。。
你随便一张 5090 都多少钱了? 4090 那些
22g 的 2080ti ,也能跑,但是就相对慢一点,而且上下文不太够 - LGZzzz6天前
bilibili 搜本地部署有很多视频讲本地部署这个事. 本地部署恼火.
- iorilu6天前
- faker52766天前
新出的 NVIDIA RTX Spark 能跑 4.1 吗?
- GavinZZ6天前
3 万内可以买那个 amd ai max 495 或者 395, 395 稍微便宜点,跑 qwen3.8 27B 还是挺流畅,40tps ,v4.1 flash 吃点力,参数量大,跑个量化版也能跑
- kerwin18746天前
一张 rtx pro 6000 都十几万了,几万预算建议去租机器玩,或者玩玩 qwen 3.8 27b 这种图一乐让它写写黄书还是可以的
- Muniesa6天前
- duanxianze6天前
搁这做梦呢??你加两个 0 都不够
- duanxianze6天前
@faker5276 不能 也只能跑 qwen 3.8 27b 这种
- penisulaS6天前
我现在 m2max 96G 就能跑 q2 量化的 deepseek v4 flash ,4.1 变大了很多,qwen 3.8 flash 能跑 q4 量化的
 koic6天前
13 万啊,得是 Mac Studio M5 Ultra 256G 16T(30+64 核)台式机 Z1U5000DG ;就这也不到 100 tok 吞吐啊,你再低配就只有 20-35 tok 了
- juzisang6天前
- AIgogo6天前
预计年底前后这些硬件会降价一波.....
- sunmacarenas6天前
dgxspark 没涨价之前 128G 的 3 万以内可以搞定,能跑 qwen3.8-next-flash-NVFP4 的模型
DeepSeek v4.1flash 本地部署还要流畅,我感觉 50w 都不一定行
- Haku6天前
两台 RTX SPARK 应该可以拿下 dsf4.1
- Haku6天前
- dododada6天前
- codehz6天前
要跑 200tok/s 这种实用速度的话预算至少乘以 100 才行,否则只能是乌龟爬
- pnczk20196天前
试过几次。感觉本地部署就是自己找罪受。
- wenxueywx6天前
之前测试 H20 跑 Qwen3.8-Flash ,结论: 短输入、短任务、低并发:快。长上下文、多会话并发等待长,体验差
- wises6天前
- mzotw2babm6天前
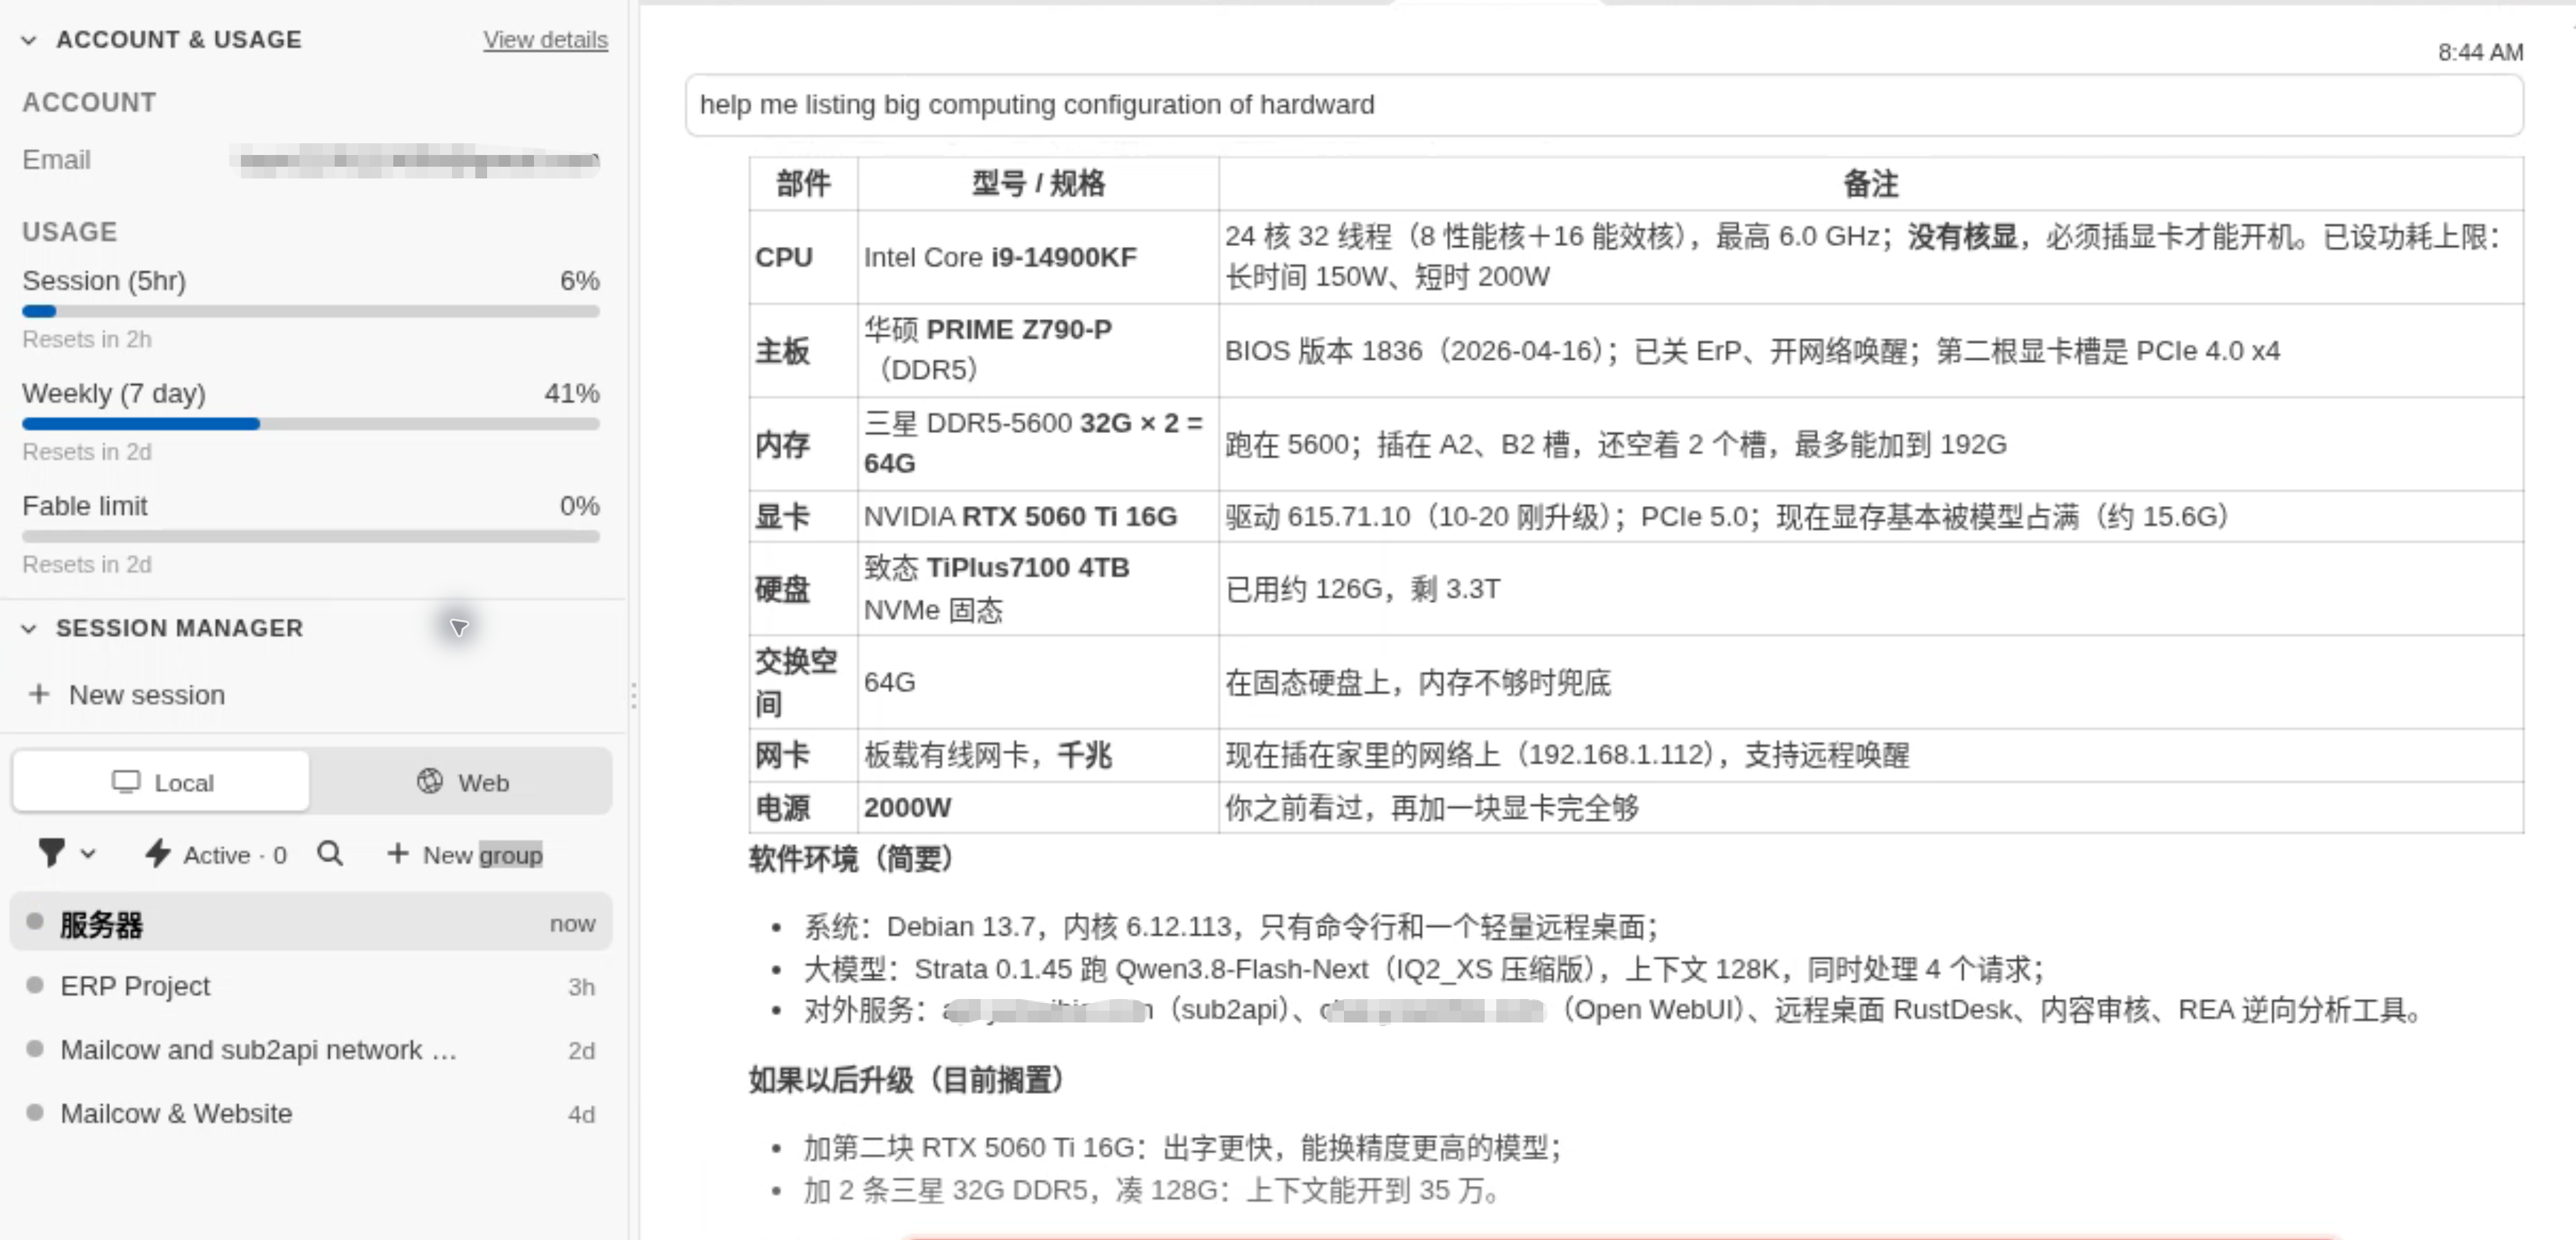
你这张 5060 Ti 能干嘛?出来搞笑的吗= =
- qiuhang6天前
3 万就别想了,加两个 0 差不多。实在要跑,跑个 qwen3.8 27b, 去阿里云租点边角料的抢占式实例,一天 50 来块。跑点黄文,黄土,黄片什么的的也不是不行。如果用来写代码,真不如把 3 万拿去买商业 llm 套餐,能用好几年呢。