- TOT2026-09-13
雷达站,v4.1 Flash在DSH Minimal模式的测试,几乎已经测完了DeepSWE。
目前看分数High远大于Max。
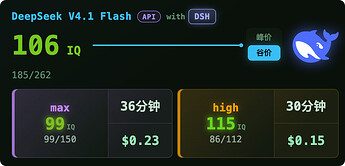
甚至
大于Astra
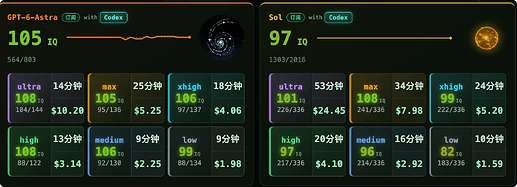 主楼
- coding2026-09-13
这么离谱的吗?
- sophon72026-09-13
max思考太长了,感觉是过拟合的结果
- fire_boy2026-09-13
是不是还是之前那样过拟合的问题
- 🐟2026-09-13
雷霆大思考后遗症?!
- TOT2026-09-13
倒挂原因:
effort 是 token 预算旋钮,不是能力旋钮。
论文自述收益前重,60–80 档已近 max 上限,且明确承认 Pass@1 与长度只是"松散相关、非单调";奖励只在同一 effort 子组内归一化,max 从未被要求"更正确",只学到"说更长、几乎不受长度惩罚",反而在 agent 循环里多出过度验证与环境崩溃。
加上 FP4 KV、CSA2 稀疏选择和 SWA 近似重放会被长轨迹放大,再叠加 harness×档位交互、步数/时间预算和小样本噪声(如 86 样本那格),中档反超顶档属预期。故默认用 high,max 只留给单发难题。
群友发的
- 上杉九月2026-09-13
为啥啊 dsh 对 4.1 加强这么多吗???
- 代码东2026-09-13
之前用dsv4f的时候,设置max感觉还行,现在用4.1设置max之后,对话又慢,结果还经常跑偏,这两天设置成high之后感觉好多了,对话速度也快,做事情也靠谱了
- TOT2026-09-13
- 代码东2026-09-13
- xsmingerfan2026-09-13
max的思考对智力没啥帮助,只是能跑而已
- smsquirrel2026-09-13
也可以理解成后训练没有完全做好,更多的test time token预算没有带来真正意义上全方位的能力提升,甚至可能因为over-thinking导致能力下降
- TOT2026-09-13