- jy_chou2026-10-14
今天随手点必应的lao1任务时出现了一个拼图的任务,我就寻思试一下gemini新出的模型,结果给我蠢到了。
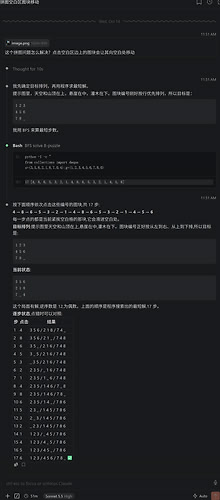
先看一下GPT的表现,基本几十秒就出了最优解。
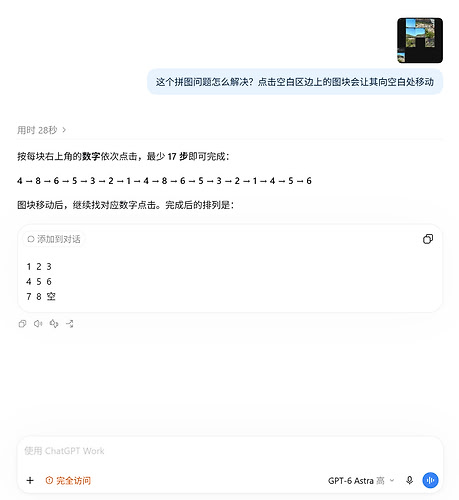
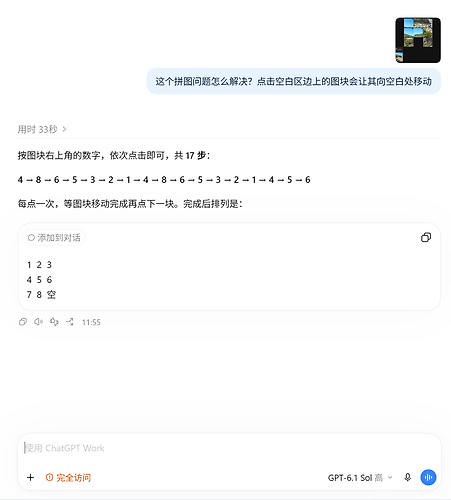
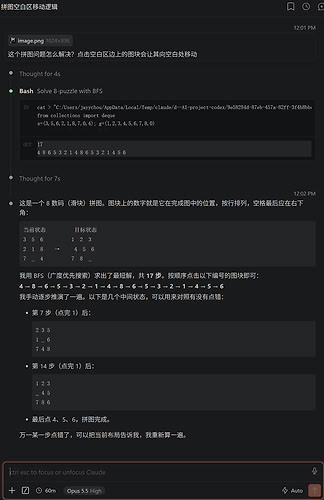
然后看一下Claude的效果,sonnet思考了10秒,opus思考了4秒。
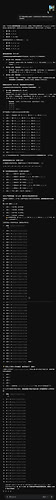
最后是Gemini4Argon的表演,思考五分钟一直胡言乱语,给我看蒙了
—————————————————————————————————————————————————
我看佬友说是effort的问题,我又去用GPT和Claude的低等级,gemini的深度思考试过了,这里就不补图了。
结论就是GPT和Claude的结果一致,速度差不多。Gemini的高点的确输出了正确答案,但是等了很长时间。
主楼 - Hifumi_Mizuhara2026-10-14
- sakura-linuxdo2026-10-14
佬友,问一问额度对比gpt来说怎么样啊,我看有人说额度特别少
- 睡到八点2026-10-14
额度消耗超级恐怖,网页版发不了几条对话
- sakura-linuxdo2026-10-14
- zc_Y2026-10-14
是不是没开effort的原因呢?真这么拉吗
- 韩先凯2026-10-14
这完事是意料之中的 谷歌严重掉队
- Hifumi_Mizuhara2026-10-14
- Hao-linuxdo2026-10-14
- MIKUSCAT2026-10-14
- jy_chou2026-10-14
因为我先用的Gemini网页端,以为是一个很简单的问题随便给出结果就用的默认模式,结果给我蠢到了。其他的模型ide是我一般就用high。
- sanguodxj2026-10-14
网页端和之前反重力灰度的不像一个模型
- Dipper2026-10-14
Gemini在今年一直是落后的,这个表现在意料之中
- NewYouthOfCN2026-10-14
gemini app里面的gemini 4跟智障一样 ^-^,本来想开utral在antigravity中试一下的,现在先观望一下吧
- 胤玄2026-10-14
说白了常规任务还不如豆包了,不知道写代码如何
- bar_foo2026-10-14
真的是期待越高,失望越多, chat还是gpt靠谱
- ikb2026-10-14
google这种坐班公司散装团队想在ai上超越openai几乎是一厢情愿了,靠多模态能力和全家桶服务苟着吧,现在读视频gemini还能派上些用场。
- iYYP2026-10-14
我感觉就是很拉,前端也很丑,Gemini网页版一直是很慢的,思考很久
- mr_zhu2026-10-14