- VrianCao6天前

inceptionlabs.ai
Diffusion at Scale: Introducing Mercury 3 – Inception
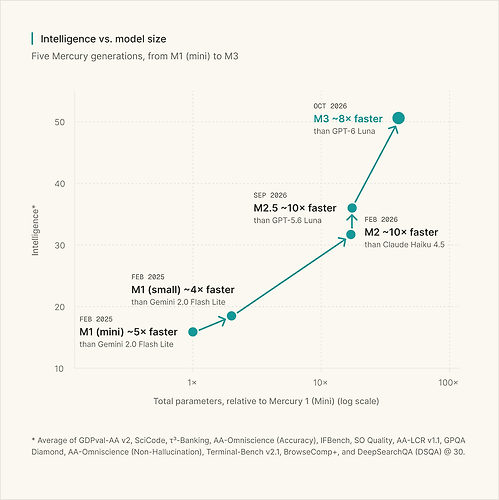
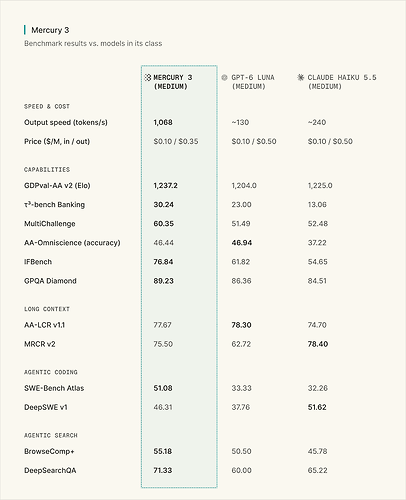
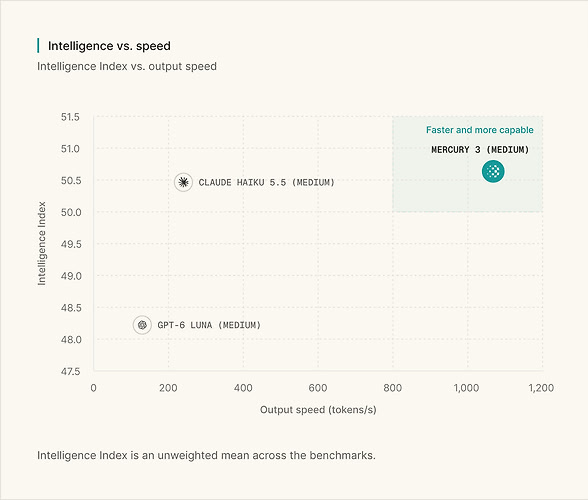
Mercury 3 is the most capable diffusion LLM released to date. It outperforms GPT-6 Luna and Claude Haiku 5.5 while running 4–8x faster at 1,000+ tokens per second.
今天我们正式推出 Mercury 3——这是迄今发布的最强大的基于扩散的大语言模型(LLM)。在一系列基准测试中,Mercury 3 的表现优于 GPT-6 Luna 和 Claude Haiku 5.5,同时运行速度快 4–8 倍,每秒可处理 1,000+ token。
Mercury 3 证明文本扩散是可以规模化的。它的参数量比 Mercury 1 大 40 倍以上,智能程度也大幅提升,但速度依旧同样快。
Mercury 3 一览
- 质量: 与 GPT-6 Luna、Claude Haiku 5.5 等前沿速度优化模型持平或更优。
- 速度: 在 NVIDIA GPU 上每秒可处理 1,068 个 token。
- 上下文: 100 万 token,相较 Mercury 2.5 的 26 万 token 显著提升。
- 价格: 每百万输入 token $0.20,每百万输出 token $0.70。
- 上线初期,Mercury 3 享 5 折优惠:每百万输入 $0.10,每百万输出 $0.35。缓存 token 在输入价格基础上再享 9 折优惠。
规模化扩散
当我们发布 Mercury 1 时,它首次证明了扩散大语言模型可用于商业应用。当时 AI 社区面临的核心问题是:扩散大语言模型能否扩展到足以在复杂用例中与自回归模型竞争?
Mercury 3 给出了答案:可以。我们将 Mercury 的总参数量扩大了 40 倍以上,在一系列标准基准测试中的智能程度从 Mercury 1(mini)到 Mercury 3 提升了 3 倍。推动自回归模型进步的缩放定律同样适用于扩散模型。
Mercury 3 is live. Diffusion scales.
主楼 - MicroSeg作者6天前
- 166886天前
坚持也不容易,respect ^-^
- VrianCao6天前
- 直到血色融化霜雪6天前
扩散模型做到这个水准,真真是震撼
- VrianCao6天前
- Jason_ghost6天前
又是哪里来的小众不知名黑马?
- 沈君墨6天前
我刚刚还在论坛搜索呢 没听说过这个
- liansishen6天前
- Kassdin6天前
我有很多同学都是做dllm的,本来dllm都濒死了只有很少几个组做了,这下都兴奋起来了
- 3GZ6天前
真的达到可用性,感觉这领域确实要爆炸了。
- Kassdin6天前
- mi_tu6天前
这算扩散大语言模型的r1时刻了吧?之前的都太烂了
- 盛世长安6天前
- Doori_Kiss6天前
让Opus5.5估计了一下,大概是200-400B的MoE
- DragonQuix6天前
已经具有实用性了啊,假如能够开源那真是本地部署模型之光。
- DFobainx6天前
有点意思 扩散模型的奠基者来耍起了