- 咪叭2026-08-27
还是很喜欢这种 A6B 的MoE模型的 ^-^
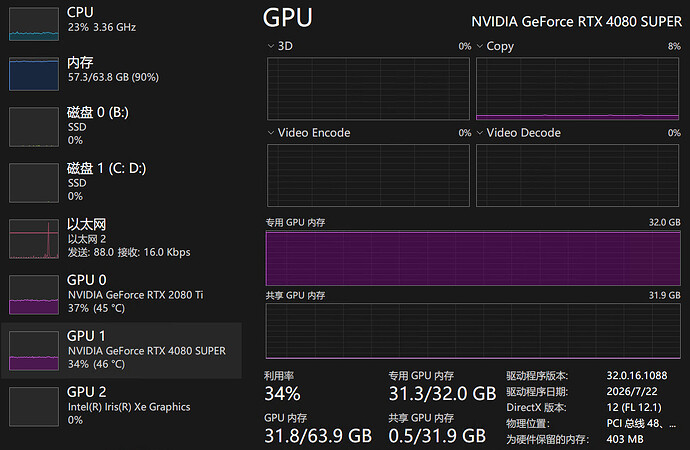
硬件配置是 4080 Super 32G【USB4】 + 2080 Ti 22G + 64G DDR5
小主机上带俩显卡坞跑的
感觉还是2080Ti 性价比高一些哈哈
不过有点极限,其实好像没加载视觉模型,也没开MTP
要是显存是64G就好了
生成速度的话大概是22-30 Token/s
估计是用了内存,或者是USB4的延迟或者带宽问题吧
Prefill并不快,350 Token/s好像,好像是需要CPU也在运算的
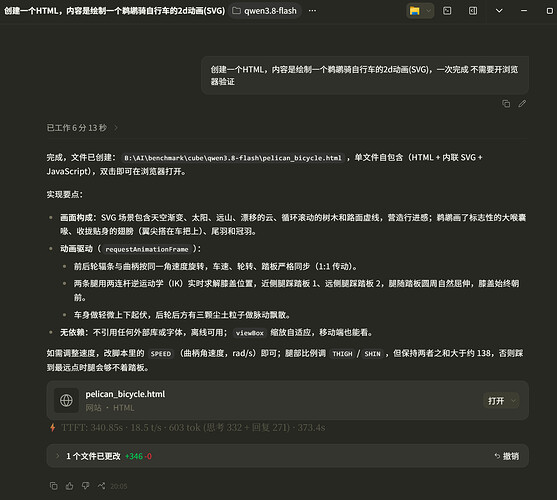
我感觉Qwen的前端是挺漂亮的哈哈
如果是 RTX Pro 6000的话应该会很爽!
附加一下启动参数(用q2kl的话 可以开 200K 上下文 q8量化):
.\llama-server.exe -m B:\models\llm\Qwen\Qwen3.8-Flash-Next\Qwen3.8-Flash-Next-UD-IQ3_XXS-00001-of-00003.gguf
--host 0.0.0.0 --port 52950
-ngl 49 -ts 28,20 -t 6 -Cr 0-11 -Crb 0-11 --cpu-strict 1--parallel 1 --flash-attn on --no-context-shift -c 168000
–alias Qwen3.8-Flash-Next --jinja--kv-unified --cache-type-k q4_0 --cache-type-v q4_0
–metrics --slot-save-path C:\Users\Administrator.unsloth\studio\cache\llama-slots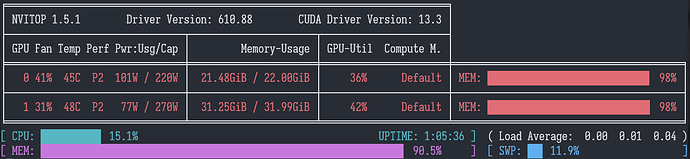
看这个运行状态,CPU 显卡一起摸鱼
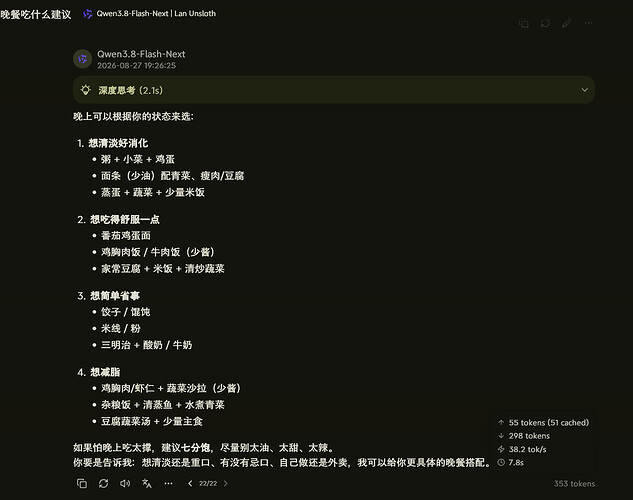
ZCode的token速度是我自己用gemini写的,估计统计出错了 ^-^
 主楼
- andmdjs2026-08-27
两显卡坞是怎么安装上去的,就一个usb4吧,还是说用pcie又引出一个口
- 咪叭2026-08-27
零刻的gti 12ultra,本身带一个pcie4x8插槽,还有个雷电4接口
- laosilaisi3天前
老哥测试strata了吗?我4080s16g+64g iq3_s能跑60-120tps